圖生影片:讓那張靜幀替你把活幹了
圖生影片是做 AI 影片最可控的方式,前提是選對靜幀,並且別再去描述畫面裡已經有的東西。
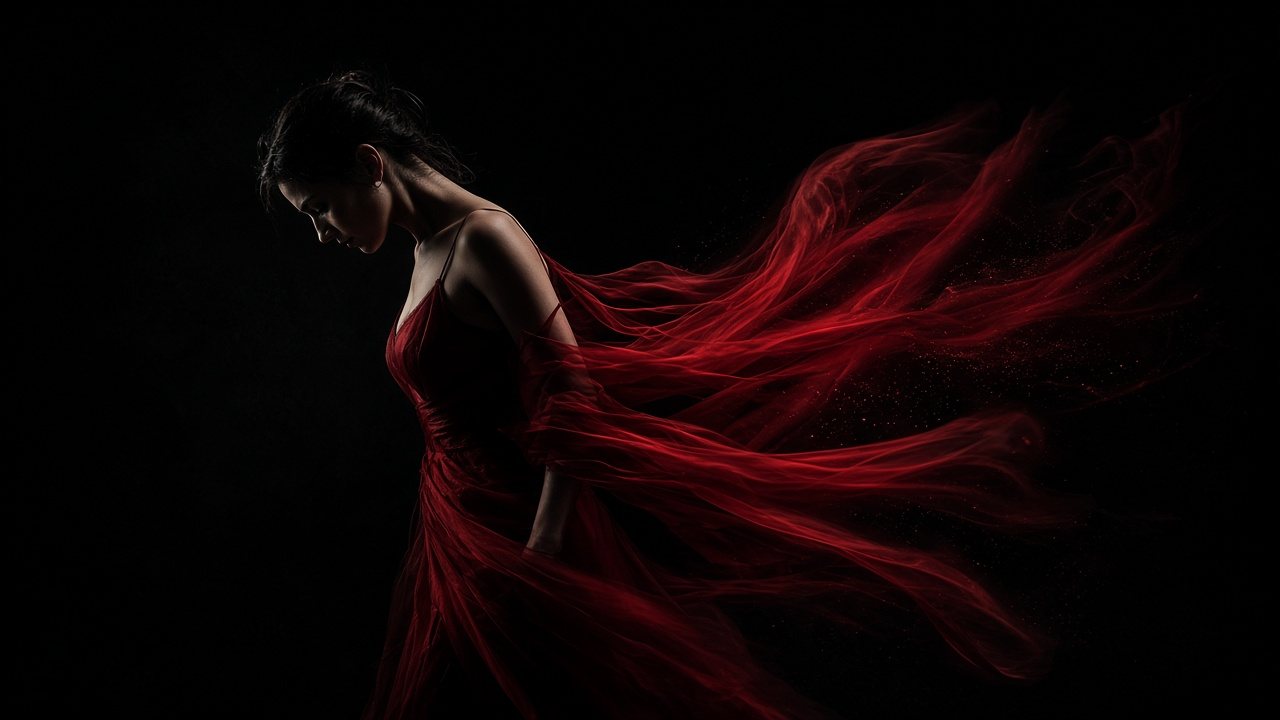
文生影片要同時憑空想出主體、場景、光線和動作;圖生影片只需要想出動作。從靜幀開始的全部理由就在這裡,而且這個理由很硬。
好動的靜幀,和跟你較勁的靜幀
生成之前,我會盯著原圖看十秒,問一個問題:它有地方可去嗎?
| 好動 | 跟你較勁 |
|---|---|
| 主體周圍有空間 | 主體被裁得緊貼畫面邊緣 |
| 光線方向明確 | 光很平、很悶,什麼都分不開 |
| 有一樣明顯能動的東西:頭髮、布料、水、煙 | 畫面很滿,所有元素都在搶 |
| 畫幅和目標影片一致 | 一張方圖,打算硬拉成 9:16 |
人像和產品圖通常比較穩。合影和密集的街景通常不太行。
寫動作,別寫畫面
這是我見得最多的錯誤:把出圖時的提示詞原樣貼進影片提示詞。模型已經有這張圖了,再描述一遍,等於把本該用來寫“變化”的字浪費掉。
黑色背景前穿紅裙的女人,戲劇性布光,優雅。
這些靜幀裡全都有了。
她緩緩向左轉身,裙襬揚起,拖在身後。鏡頭慢慢推近。
一個動作,一個運鏡。單個鏡頭通常這樣就夠了。
靜幀負責選角和佈景,提示詞負責導演。
首尾幀:什麼時候值得用
Paper Gen 可以同時設定首幀和尾幀,由模型生成中間的運動。我一般在三種情況下用它:產品轉過來露出另一面;變身類鏡頭,終點狀態是定死的;以及必須落在某個特定構圖上、好跟下一個鏡頭接上的畫面。
其他情況,一張首幀加一句動作提示詞更簡單,也給模型留了點給你驚喜的餘地。
開啟 AI 影片生成器上傳一張靜幀,或者直接用剛生成的那張。常見問題
起始圖片可以用什麼?
照片、人像、產品圖、插畫或草圖都可以。
設定尾幀有什麼用?
模型會生成從首幀過渡到尾幀的運動。