画像から動画AI:重い仕事は静止画にまかせる
画像から動画は、AI動画を作るうえでいちばん制御しやすい方法です。正しい静止画を選び、絵にすでに写っているものを説明するのをやめさえすれば。
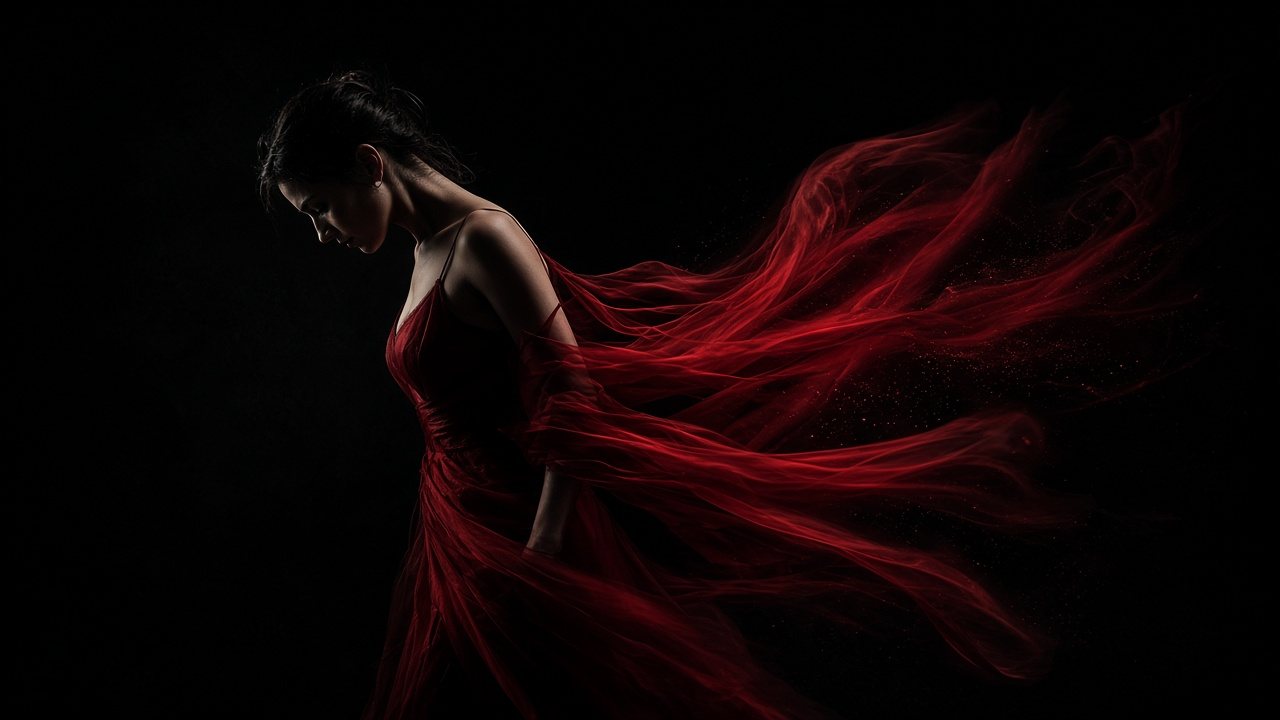
テキストから動画は、被写体も舞台も光も動きも一度に作り出さなければなりません。画像から動画が作るのは動きだけ。静止画から始める理由はこれに尽きますし、十分に強い理由です。
動かしやすい静止画、そうでない静止画
何かを生成する前に、元画像を10秒ほど眺めて、この絵に行き先があるかを自問します。
| 動かしやすい | 抵抗してくる |
|---|---|
| 被写体のまわりに余白がある | 被写体がフレームの端ぎりぎりで切れている |
| 光の方向がはっきりしている | 平板で濁った光で、何も分離していない |
| 動きそうなものがはっきりひとつある:髪、布、水、煙 | すべてが主張し合うごちゃついた場面 |
| 作りたい動画と同じアスペクト比 | 9:16に引き伸ばすつもりの正方形トリミング |
ポートレートと商品写真はたいてい安全。集合写真や密集した街の風景はたいてい難しい。
絵ではなく動きを書く
いちばんよく見る間違いです。元の画像プロンプトを動画プロンプトに貼りつけてしまう。モデルはもう絵を持っています。繰り返すと、変化を書くための言葉が無駄になります。
A woman in a red dress against a black background, dramatic lighting, elegant.
これは全部、静止画がもう言っています。
She turns slowly to her left; the dress lifts and trails behind her. Slow push-in.
動きがひとつ、カメラの動きがひとつ。ワンショットならたいていこれで足ります。
静止画はキャスティングと美術。プロンプトは演出。
最初と最後のフレーム:使う価値があるとき
Paper Genでは最初と最後のフレームを指定でき、その間の動きを生成します。私が使うのは3つの場面です。製品が回って反対側を見せるとき、終わりの状態が決まっている変身、そして次のショットにきれいにつなぐため特定の構図で着地させたいショット。
それ以外は、最初のフレームひとつと動きのプロンプトのほうがシンプルで、モデルが驚かせてくれる余地も残ります。
AI動画生成を開 く静止画をアップロードするか、生成したばかりのものを使います。よくある質問
開始画像には何が使えますか?
写真、ポートレート、商品写真、イラスト、スケッチ。
最後のフレームを指定すると何が起きますか?
最初のフレームと最後のフレームをつなぐ動きをモデルが生成します。