它能做什么
Kling 3.0 的功能:由你调度的分镜,随画面而来的声音

五个分镜,同一组角色,在你写的地方切换
一只柴犬叼起一个面包,面包店店员沿着积雪的街道追出去。把每个分镜连同它的秒数按顺序写好,Kling 3.0 就会在它们之间切换:这段 15 秒的镜头里,切点落在第 3、6、10 和 13 秒。同一只狗、同一位戴酒红色毛线帽的店员,贯穿全部五个分镜。

场景里的人声,听得见的雪
一位旅行者在雪夜里自拍,对着镜头说出她的台词。Kling 3.0 把人声、踩雪的咯吱声和远处的人群声与画面一起生成,所以话语和口型对得上。每句台词都要写明角色名、语气和语言。Kling 列出的语言有中文、英语、日语、韩语和西班牙语。

四个分镜,拍完一次归来
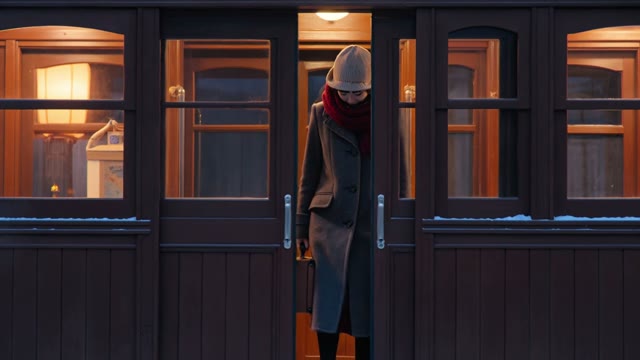
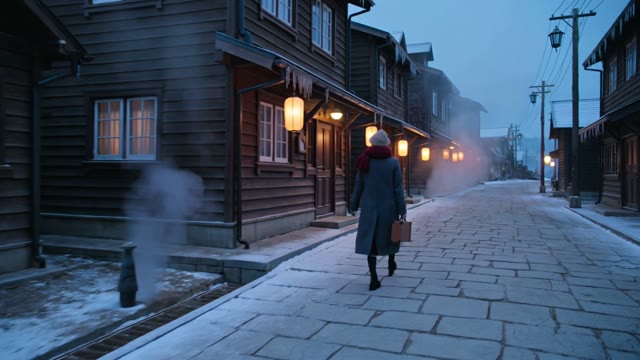
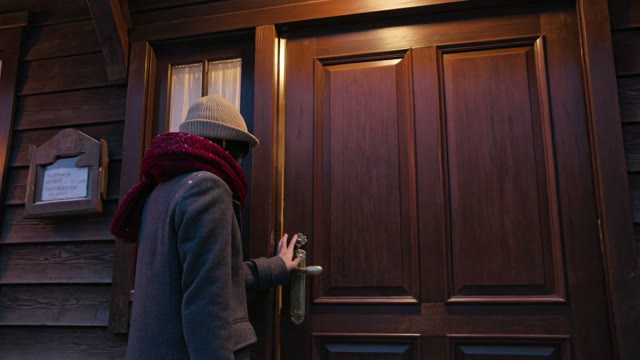
分镜 1 列车进站,分镜 2 她走下车,分镜 3 蒸汽弥漫的街道,分镜 4 旅馆的门。每个分镜都写上秒数,总和为 15 秒,所以切点落在第 4、8 和 12 秒。每个分镜里都用同样的话描述她的外套、围巾和帽子,她才会始终是同一个人。
开始生成
适用场景
用 Kling 3.0 做广告、故事和社媒视频

产品与手艺. 茶倒进白瓷杯,茶面上浮着一片雪花,再缓缓拉远到窗边的灯笼。十秒内三个分镜,倒茶声已经在音轨里。
- 开发方
- 快手
- 时长
- 每次生成 3 到 15 秒
- 画质
- 720p 标准、1080p 专业或 4K
- 起点
- 文字提示词,或首帧和尾帧
- 分镜
- 每次生成最多 6 个,每个分镜各自写明秒数
- 声音
- 台词、音效和配乐与画面一起生成,可以关闭
- 画幅
- 1:1、9:16 或 16:9
- 使用入口
- VibePaper 的 Paper Gen 和画布
用 Kling 3.0 制作的视频
开始生成

Kling 3.0 常见问题:分镜、声音、首尾帧和画质
Kling 3.0 是什么?
Kling 3.0 是快手的视频模型。它可以从文字提示词或首帧和尾帧出发,一次生成 3 到 15 秒、带声音的视频,并且能按写进提示词里的多个分镜来切换镜头。在 VibePaper 中,它可用于 Paper Gen 和画布,模型列表里的名字是 Kling V3。
视频能有多长,画质是多少?
每次生成 3 到 15 秒,画质可选 720p 标准、1080p 专业或 4K。想省积分,可以先用 720p 标准试一个镜头,满意后再用更高档位生成。本页第一条视频是 1080p 专业,其余都是 720p 标准。
Kling 3.0 会生成声音吗?
会。台词、环境声、音效和配乐与画面一起生成。声音开关默认打开,也可以关闭。每句台词按角色名、语气和语言来写,并给每位说话者一个固定的称呼。Kling 列出的语言有中文、英语、日语、韩语和西班牙语,同一场景里可以切换语言。
能在多个分镜之间切换吗?
可以。把分镜写成分镜 1、分镜 2、分镜 3,并写明各自的秒数,让秒数之和等于你设定的时长。Kling 单次生成最多支持 6 个分镜。我们用 5 个分镜做了一次 15 秒的测试,切点落在第 3、6、10 和 13 秒,与我们写的相差不到半秒。不写分镜列表,就会得到一个连续的长镜头。
可以用首帧和尾帧吗?
可以。添加一张图作为首帧、一张作为尾帧,在提示词里描述两者之间的动作。请描述动作和镜头,不要重复描述你已经给出的画面。
可以添加参考图、参考视频或延长片段吗?
这个模型不支持。这里的 Kling 3.0 从提示词或首帧和尾帧开始。需要参考图或参考视频,请用 Kling 3.0 Omni;需要最多 9 张图片、3 段视频和 3 段音频作为参考,请用 Seedance 2.0。
可以告诉它哪些东西不要出现吗?
没有反向提示词输入框,所以请直接说你想要什么,而不是要避开什么。要写"素面的纸灯笼",而不是"没有字的灯笼";要写"晴朗的天空",而不是"没有云"。
支持哪些画幅?
支持 1:1、9:16 和 16:9,一个模型就能覆盖竖屏社媒、方形帖子和宽屏。
我的提示词为什么被拒绝了?
提到已有电影、歌曲、艺术作品或真实人物的提示词可能会被拒绝。请改用你自己的话来描述原创角色和场景。
生成的视频可以商用吗?
可以。视频无水印下载,可用于广告、客户项目和社交渠道。你需要确保自己有权使用上传作为首帧或尾帧的图片。
博客:使用指南与模型介绍
实用的上手指南,和这里能用到的模型介绍:每个模型擅长什么、提示词怎么写、怎样在画布上做出更好的结果。