它能做什么
Seedance 2.5 的能力:一个模型包办整场拍摄

一镜到底拍完整个场景,声音也在其中
把几条短的 AI 视频拼在一起,人脸、光线和道具往往在每个接缝处走样。Seedance 2.5 能一镜保持长达 30 秒,同一个骑手从清晨一路穿过城市到日落。车铃、车流和配乐与画面同时生成,直接落在动作上,不用事后再叠加。

先用 480p 试镜头,再用 1080p 出成片
打开草稿模式,先用 480p 试时间点、构图和运镜,省下积分。某一条满意了,再单独用 1080p 出成片。成片单独计费,所以最高画质只花在你留下的镜头上。
- 480p 草稿
- 1080p 成片

多模态参考:选角、换装,然后开拍
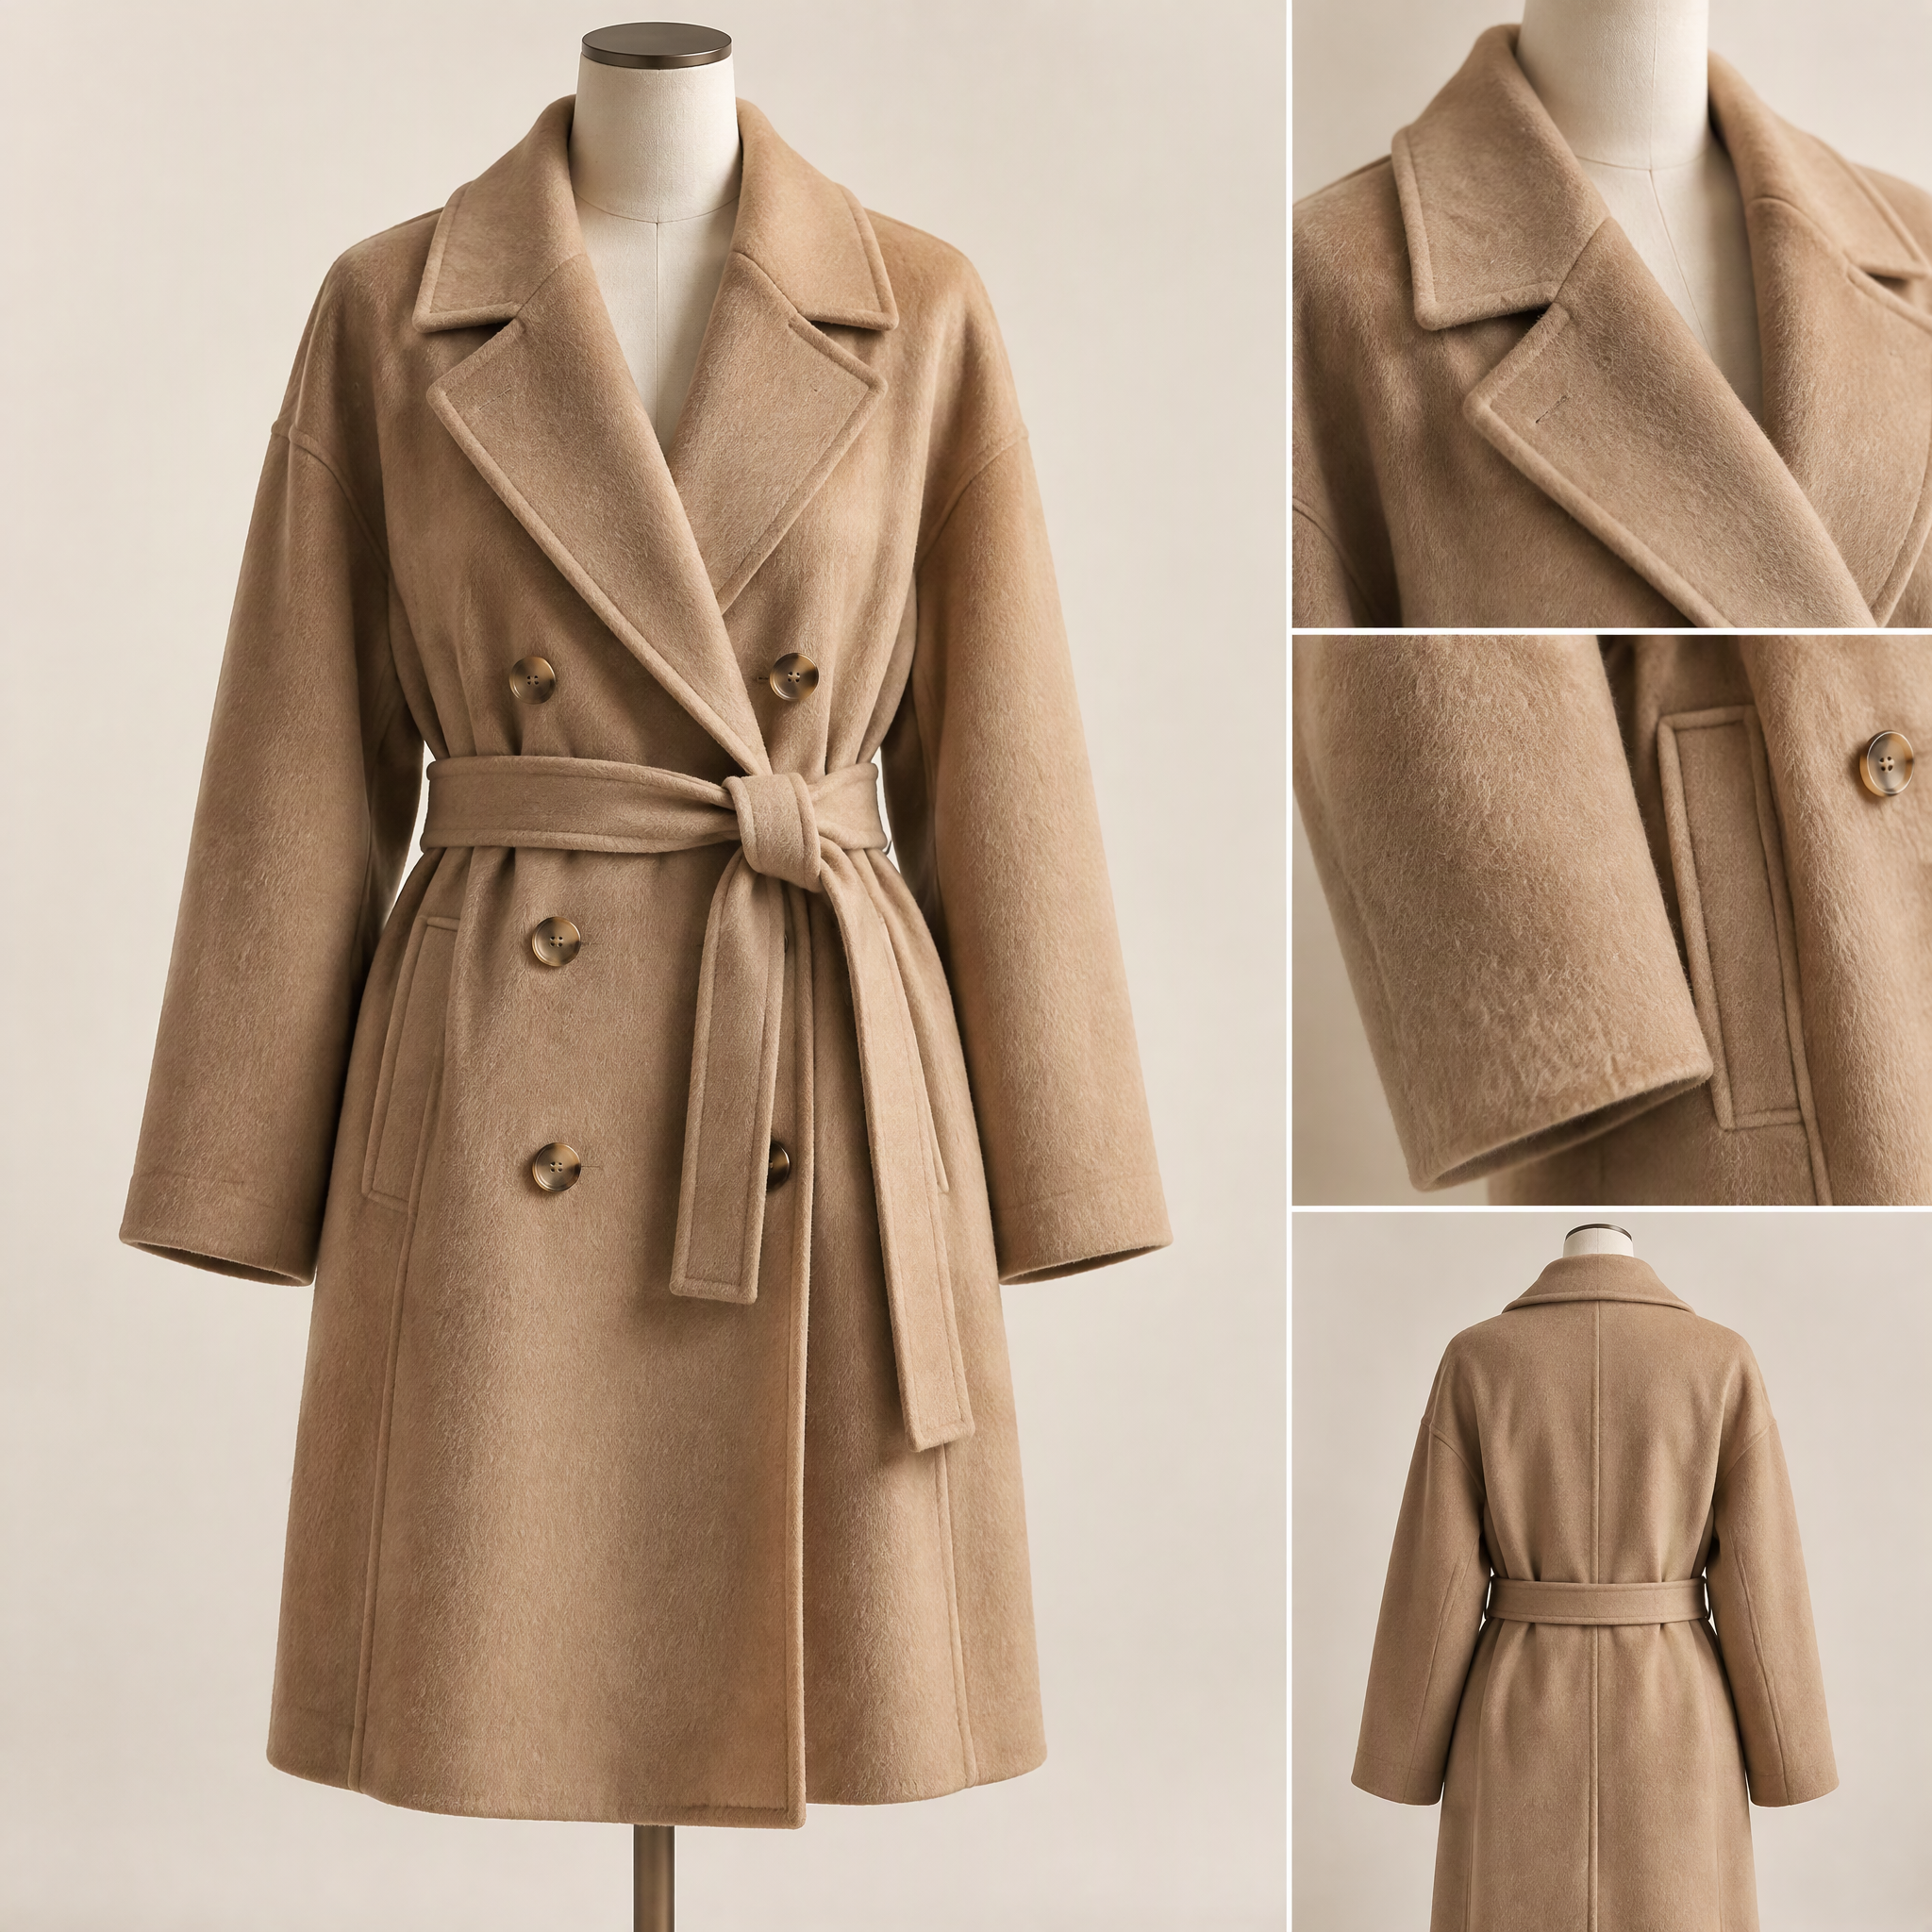
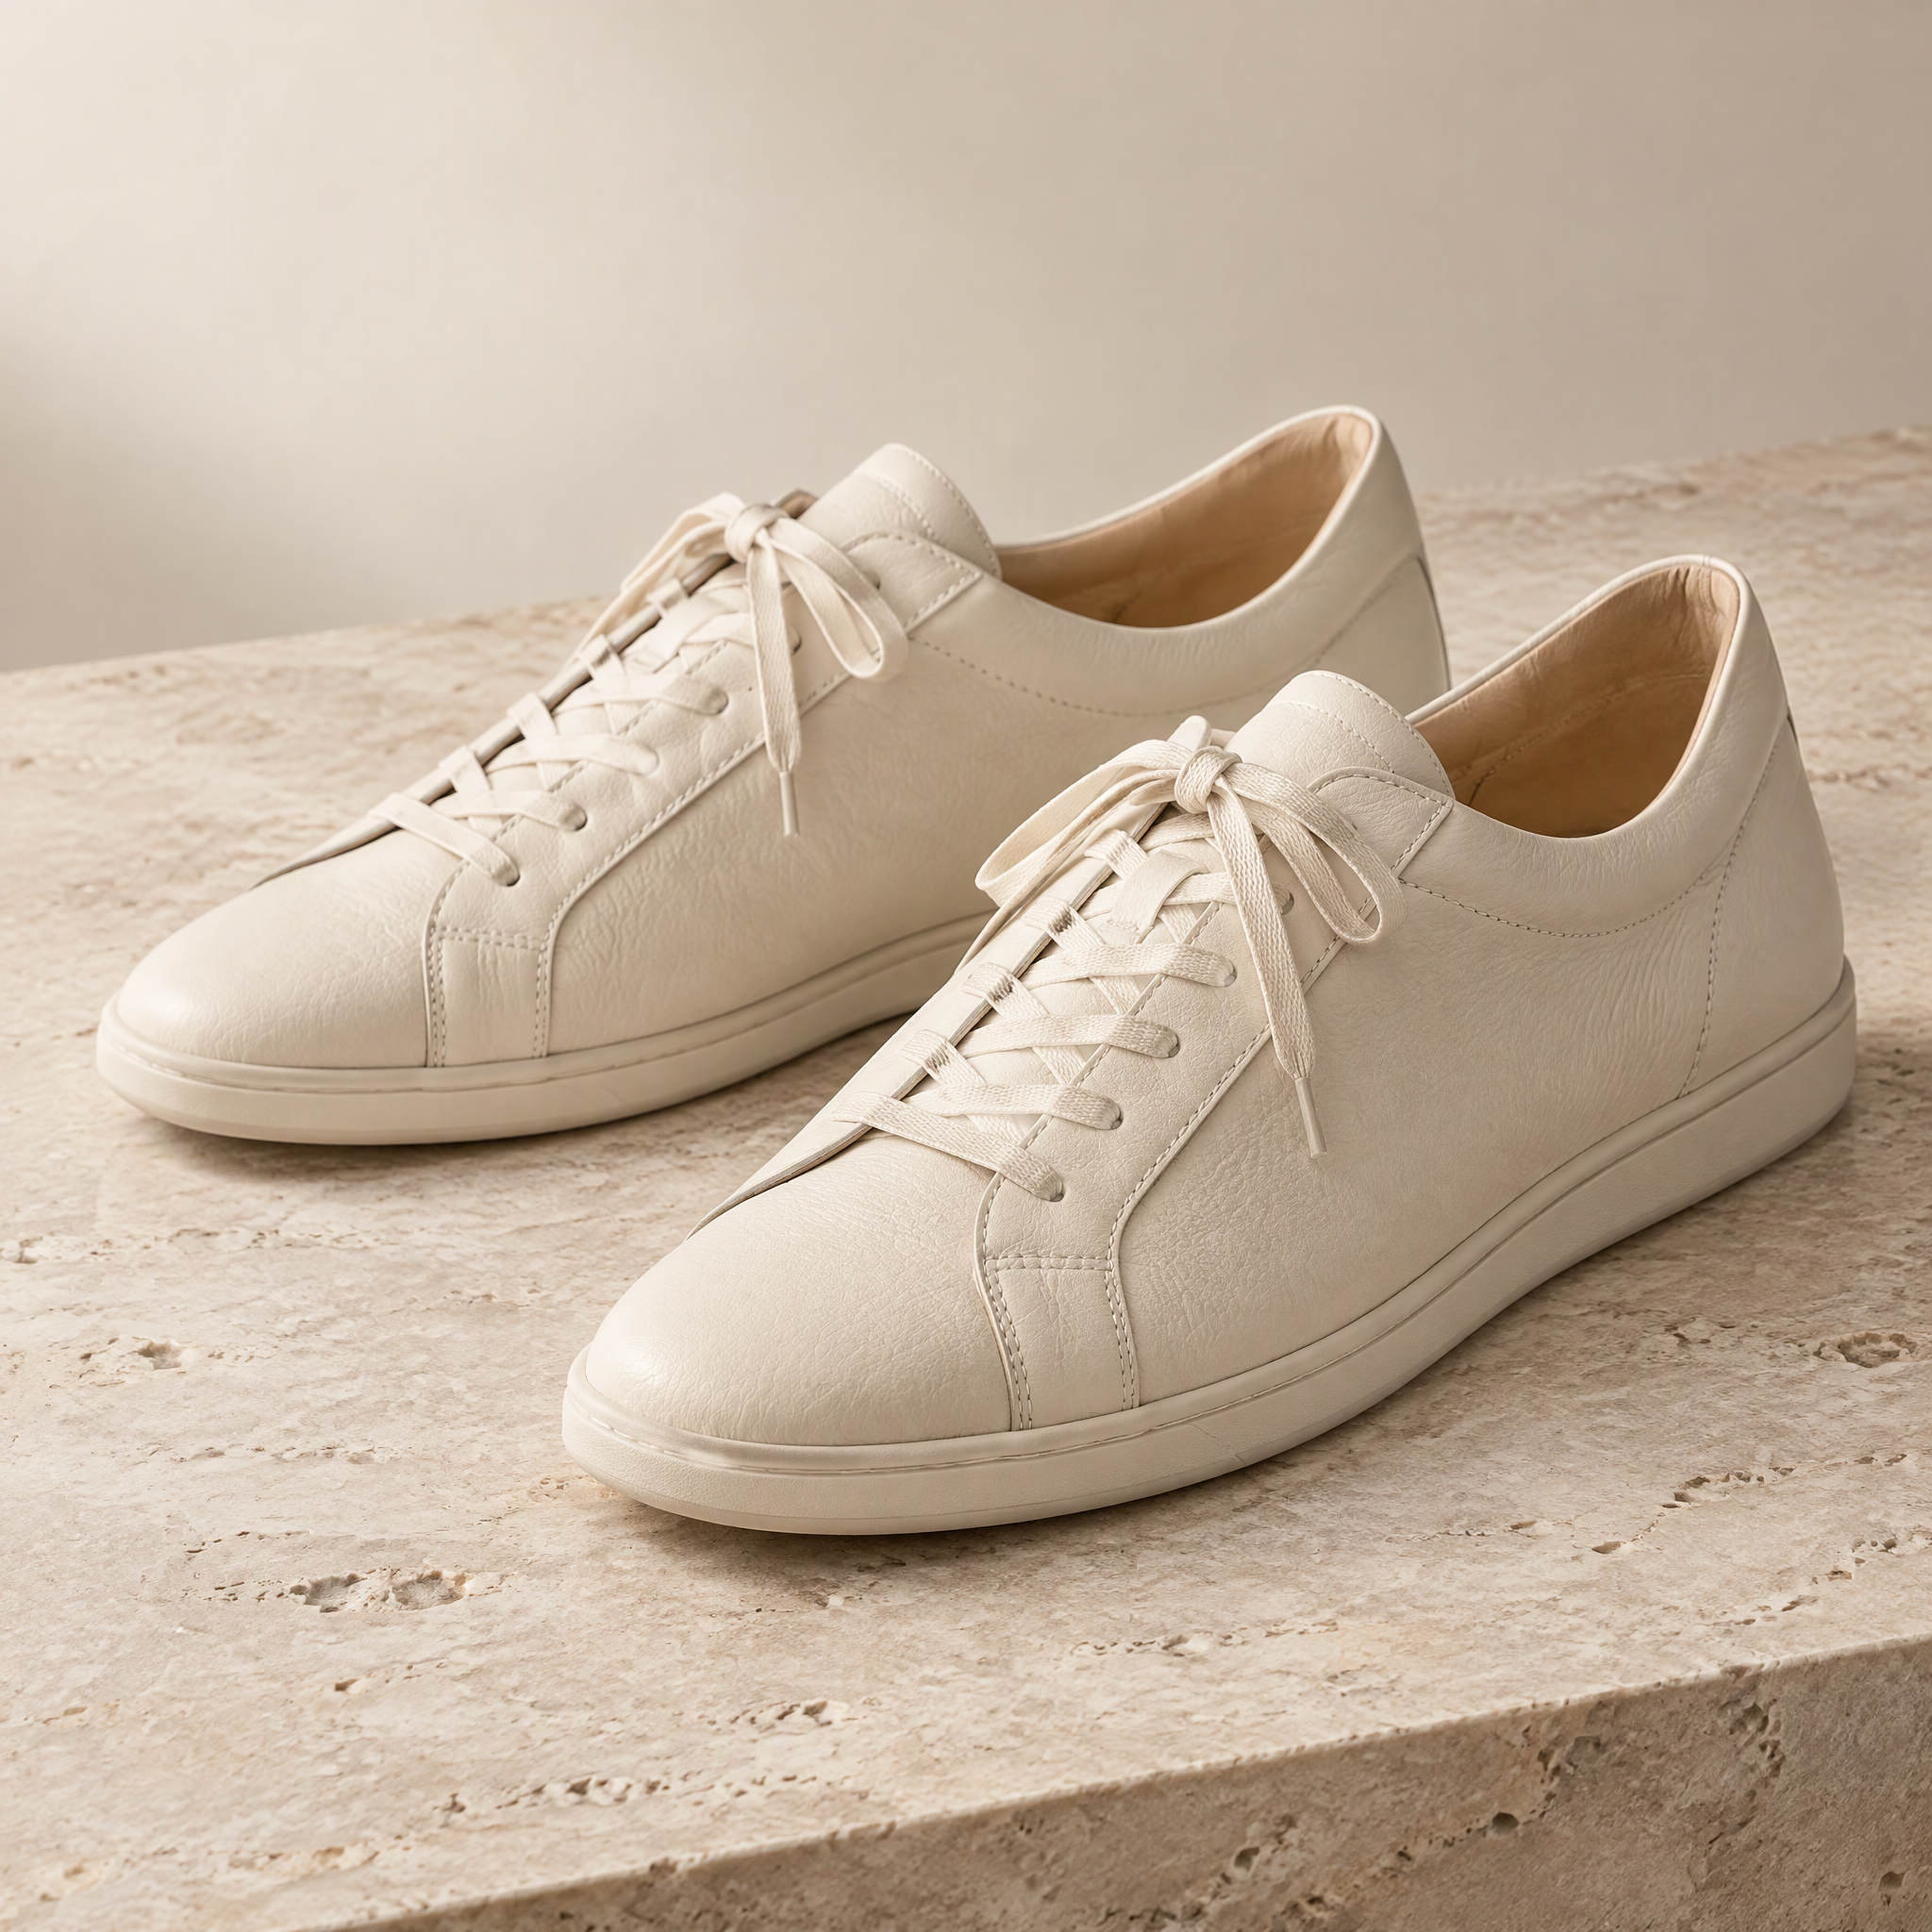
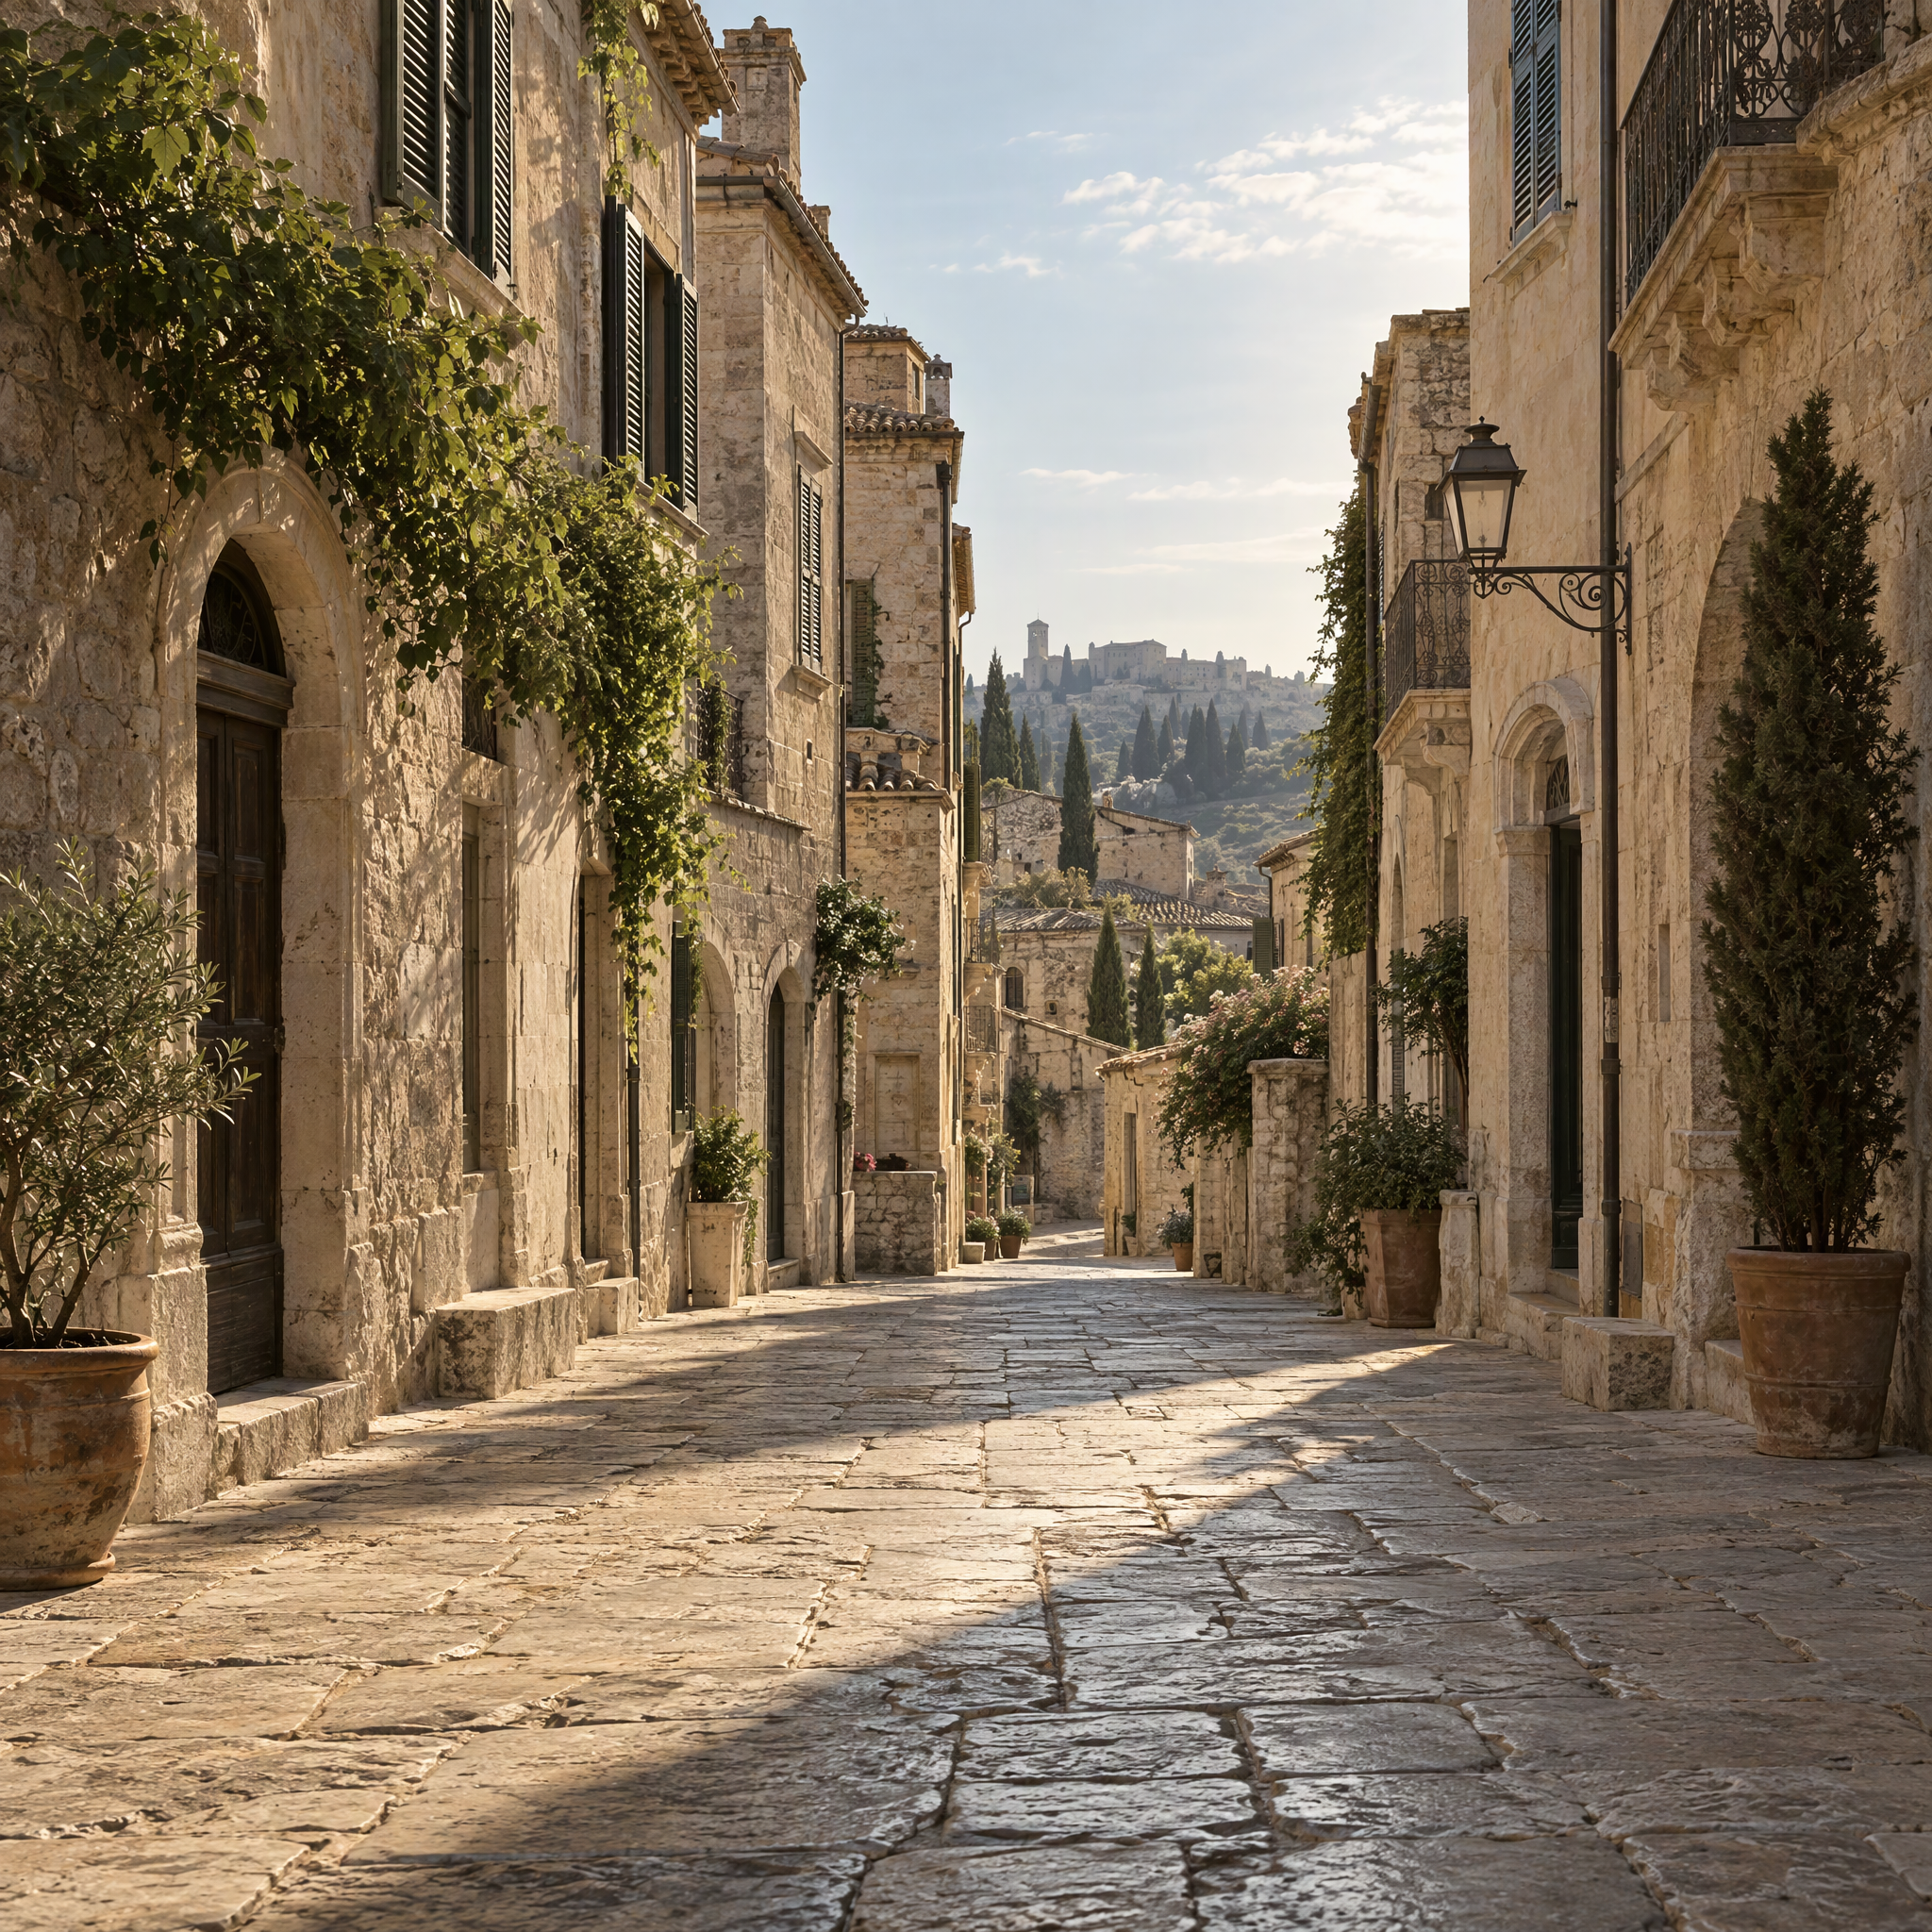
给 Seedance 2.5 一张脸、一件大衣、一双鞋和一条街,它就围绕这些来搭建镜头。一次生成最多可用 30 张图片、10 段视频和 10 段音频:用静态图锁定人物或产品,用视频复刻运镜,用音频定下声音或节拍。记得在提示词里写清每个文件的用途。
开始生成
适合做什么
Seedance 2.5 适合广告、故事和社交视频

产品广告. 倒酒、飞溅和主角镜头一镜完成,气泡声和碰杯声已经在音轨里。


- 开发方
- 字节跳动 Seed
- 时长
- 每次生成 4 到 30 秒,或自动
- 分辨率
- 480p 或 720p。先用 480p 出草稿,再用 1080p 出成片
- 起点
- 文字提示词、首帧和尾帧,或参考素材
- 参考素材
- 最多 30 张图片、10 段视频和 10 段音频,每段时长 2 到 30 秒
- 声音
- 台词、音效和配乐与画面一起生成,默认开启
- 画面比例
- 自适应、1:1、3:4、4:3、9:16、16:9 或 21:9
- 在哪里使用
- VibePaper 的 Paper Gen 和画布
生成步骤
三步做出一条 Seedance 2.5 视频
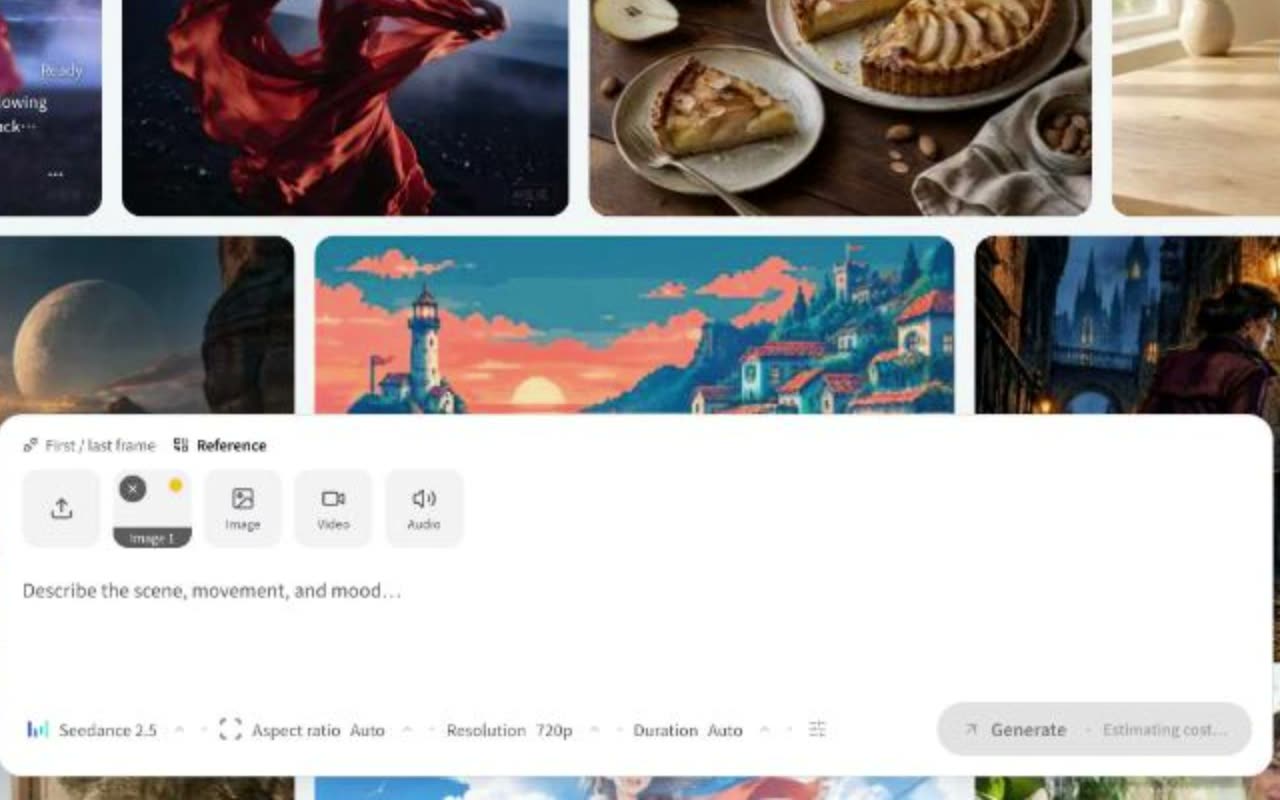
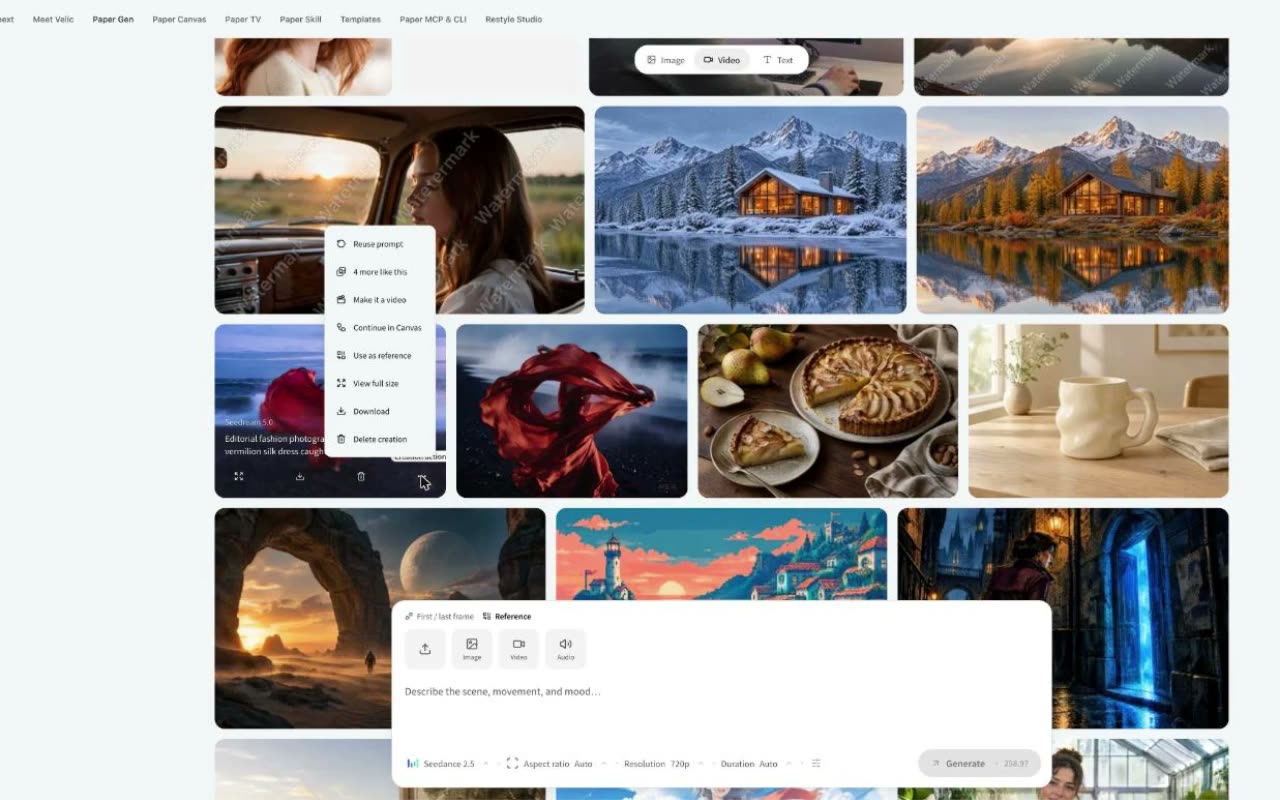 Paper Gen 真实录屏1
添加参考
可选:首帧、人脸、产品或场景,用来确定画面风格和角色。
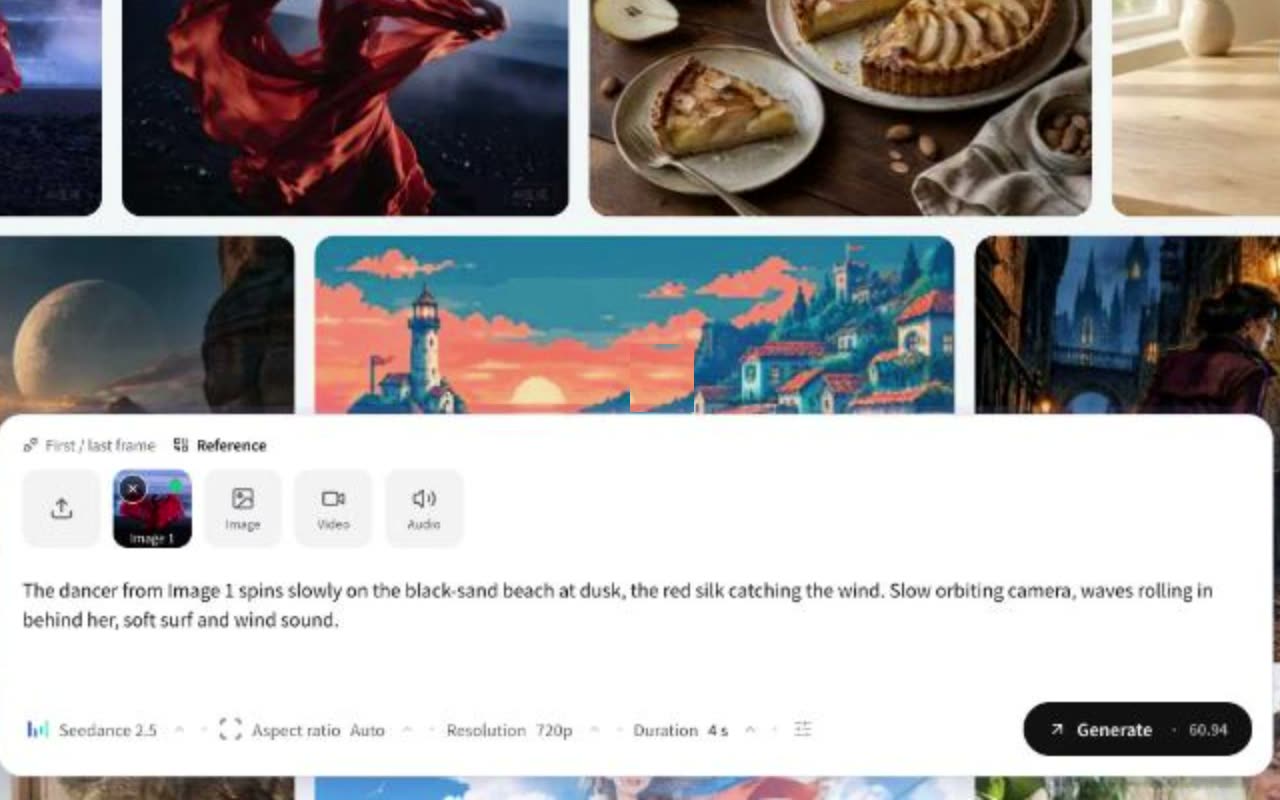
 Paper Gen 真实录屏2
写提示词
描述主体、动作、运镜、光线,以及你想要的声音。
 Paper Gen 真实录屏3
生成并下载
先看按钮上的价格,再生成,下载时没有水印。
由 VibePaper 团队于 2026 年 11 月 12 日在 Paper Gen 中录制。提示词、4 秒时长设置、按钮上的积分价格和最终成片,都来自同一次真实运行,不是示意图。
用 Seedance 2.5 做出的作品
开始生成


Seedance 2.5 常见问题:时长、声音、参考素材和价格
Seedance 2.5 是什么?
Seedance 2.5 是字节跳动 Seed 团队的视频模型。它可以根据文字提示词、首帧和尾帧,或图片、视频和音频参考,一次生成最长 30 秒、声音同步的视频。在 VibePaper 里,它可以在 Paper Gen 和画布中使用。
和 Seedance 2.0 相比有什么新变化?
更长的单镜和更多的参考素材。Seedance 2.5 最长 30 秒,Seedance 2.0 是 15 秒;参考素材最多 30 张图片、10 段视频和 10 段音频,Seedance 2.0 则是 9 张、3 段和 3 段。
视频最长多久,分辨率是多少?
每次生成 4 到 30 秒,分辨率为 480p 或 720p。想在测试时省积分,可以先出 480p 草稿,满意的那一条再用 1080p 出成片,成片单独计费。
Seedance 2.5 生成一条视频要多少钱?
价格取决于时长和分辨率,生成按钮上会在你确认之前显示价格。我们 2026 年 11 月 12 日在 Paper Gen 里的一次实测中,一条 4 秒、720p、带一张参考图的视频显示为 60.94 积分;同样的提示词如果保持自动时长,显示约为 259,所以测试时请自己设定时长。
Seedance 2.5 生成一条视频要多久?
取决于排队情况和时长。上面步骤中录制的 4 秒 720p 视频,大约用了 10 分钟才完成。想在花钱出成片之前先确认镜头,480p 草稿是更快的办法。
Seedance 2.5 会生成声音吗?
会。台词、环境声、音效和配乐与画面一起生成,所以会跟着动作走。声音默认开启,生成前也可以关掉。
可以用多少个参考素材?
一次生成最多可用 30 张图片、10 段视频和 10 段音频,视频和音频每段时长 2 到 30 秒。记得在提示词里说明每个文件的用途,比如人脸、大衣或街景。
能让同一个角色在不同镜头里保持一致吗?
在同一次生成里可以。每个镜头都用同样的方式描述这个角色,或者加一张人脸和服装的参考图。如果多张脸都要保持一致,建议控制人数。
为什么我的提示词被拒绝了?
提示词里点名已有的电影、歌曲、艺术作品或真实人物,可能会被拒绝。请改用你自己的话来描述原创角色和场景。
生成的视频可以商用吗?
可以。视频下载时没有水印,可用于广告、客户项目和社交渠道。你上传作为参考的图片、视频和声音是否有权使用,需要由你自己负责。
博客:使用指南与模型介绍
实用的上手指南,和这里能用到的模型介绍:每个模型擅长什么、提示词怎么写、怎样在画布上做出更好的结果。