VIBEPAPER JOURNAL / AI CREATION
Wan 3.0 實測:一鏡到底的長鏡頭怎麼用、我們看到了什麼,以及還沒驗證的部分
VibePaper · 更新於
Wan 3.0 是阿里雲推出的影片模型,主打更長的一鏡到底場景。官方公佈的上限是一次生成最長 30 秒、1080p,並且可以同時生成聲音,還能把圖片、影片和音頻作為參考輸入。我們在 VibePaper 的影片生成器裡生成了一段 5 秒、1080p 的測試片段:雨中的夜市,最後停在一位在拱門下拉大提琴的人身上。這段片段不能證明 30 秒的上限,它只展示了我們測試的時長下,一個連續鏡頭大致是什麼樣子,以及哪些官方數字是我們還沒有親眼見到的。
- Wan 3.0
- AI 影片生成
- 一鏡到底
- 參考生影片
- 原生聲音
一覽
| 能力 | 官方公佈的數字或表現 | 實際意味著什麼 |
|---|---|---|
| 單次時長 | 每次 2 到 30 秒;預設 5 秒;設為 -1 時由模型按提示詞選擇時長 | 生成前先設定時長。我們唯一的測試片段是 5 秒。 |
| 分辨率與幀率 | 480P、720P 或 1080P(API 預設 1080P);30 fps | 我們的測試片段是 1080p。本文網頁上的版本是 720p。 |
| 聲音 | 聲音參數預設開啟,輸出會帶音軌 | 測試檔案有音軌。我們發佈的網頁版是靜音的。 |
| 參考素材 | 最多 10 張圖片;5 段影片和 5 段音頻,各自合計不超過 15 秒 | 參考模式可以添加這些素材。每個檔案都應該回答鏡頭裡需要回答的一個問題。 |
| 首尾幀 | 首幀模式和首尾幀模式各接受一張圖片 | 這兩種模式不接受音頻參考。 |
| 輸出 | MP4,H.264 編碼 | 可以直接用於剪輯或放到頁面上。 |
Wan 3.0 改了什麼
最明顯的變化是時長。前幾代萬相更多圍繞較短的片段,Wan 3.0 把一次生成的上限提到了 30 秒。API 文檔把它描述為基於參考的模型:圖片、影片和音頻可以一起輸入,輸出也可以帶聲音。
對創作者來說,這改變了第一次嘗試的樣子。過去需要幾段短片再粗略拼接的場景,原則上可以先當作一個鏡頭來試。但一個場景能不能從頭到尾站得住,要靠每個人用自己的素材去檢驗。官方公佈的數字是上限,不是對每條提示詞的承諾。
Wan 3.0 的能力細節
一鏡到底,最長 30 秒
API 接受的時長是 2 到 30 秒,幀率 30 fps,預設 5 秒。把時長設為 -1,會啟用智能時長,由模型根據提示詞決定長度。我們還沒有跑過 30 秒的生成,所以無法描述更長的鏡頭怎樣保持連貫。我們 5 秒片段能說明的內容,放在下面的實測部分。
同一次生成裡的聲音
聲音參數預設為開啟,也就是說生成的影片會包含音軌。我們測試的檔案有一條立體聲 AAC 音軌。我們沒有做專門的聽感評估,所以這篇文章不評判聲音的質素。我們發佈的網頁版去掉了音軌:頁面以靜音方式自動播放,去掉音軌也讓檔案更小。
圖片、影片與音頻參考
參考生影片最多接受 10 張圖片、5 段影片和 5 段音頻。每段參考影片為 1 到 15 秒,所有參考影片的合計時長不能超過 15 秒;參考音頻的規則相同。音頻在參考模式裡作為參考輸入,可以和參考圖片、參考影片一起使用。首幀模式和首尾幀模式只接受圖片。
產品卡片上寫著,這些參考能讓 Wan 3.0 在整個鏡頭裡跟住同一個角色。API 文檔說明了輸入是怎樣傳入的,但沒有說明一個角色在 30 秒裡能保持到什麼程度,這一點我們沒有測試過。
我們的測試片段能說明什麼
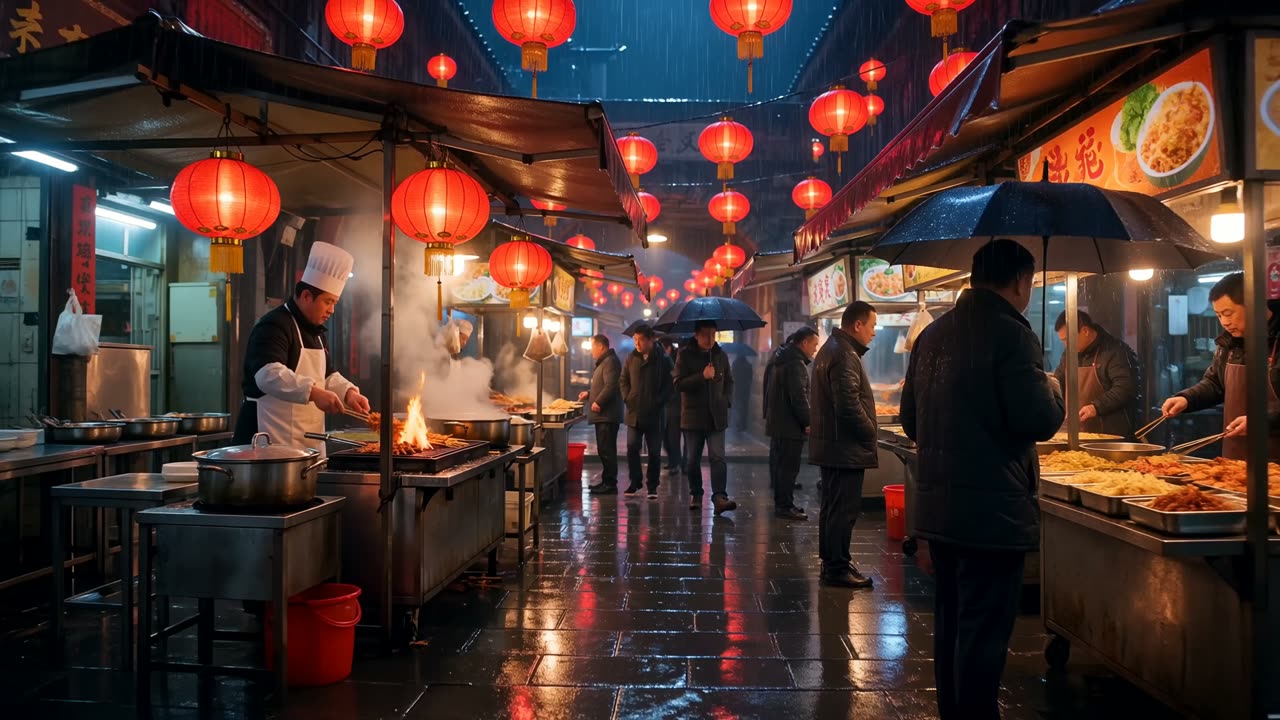
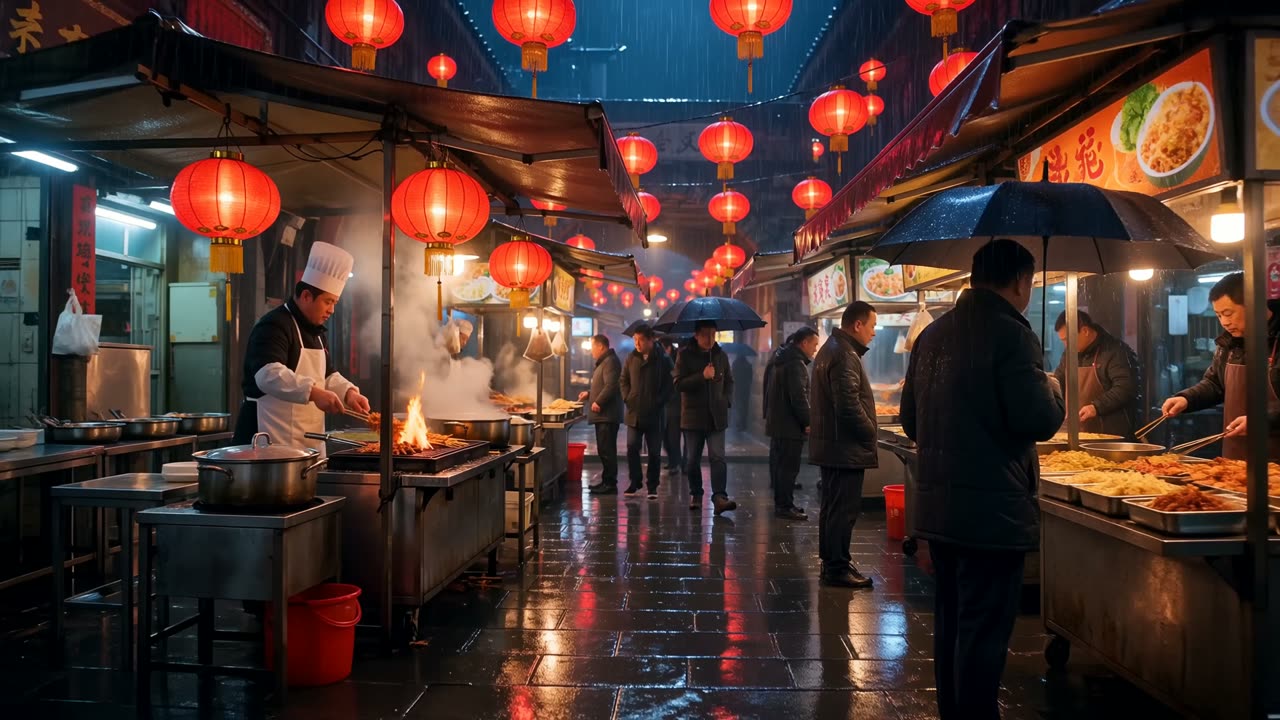
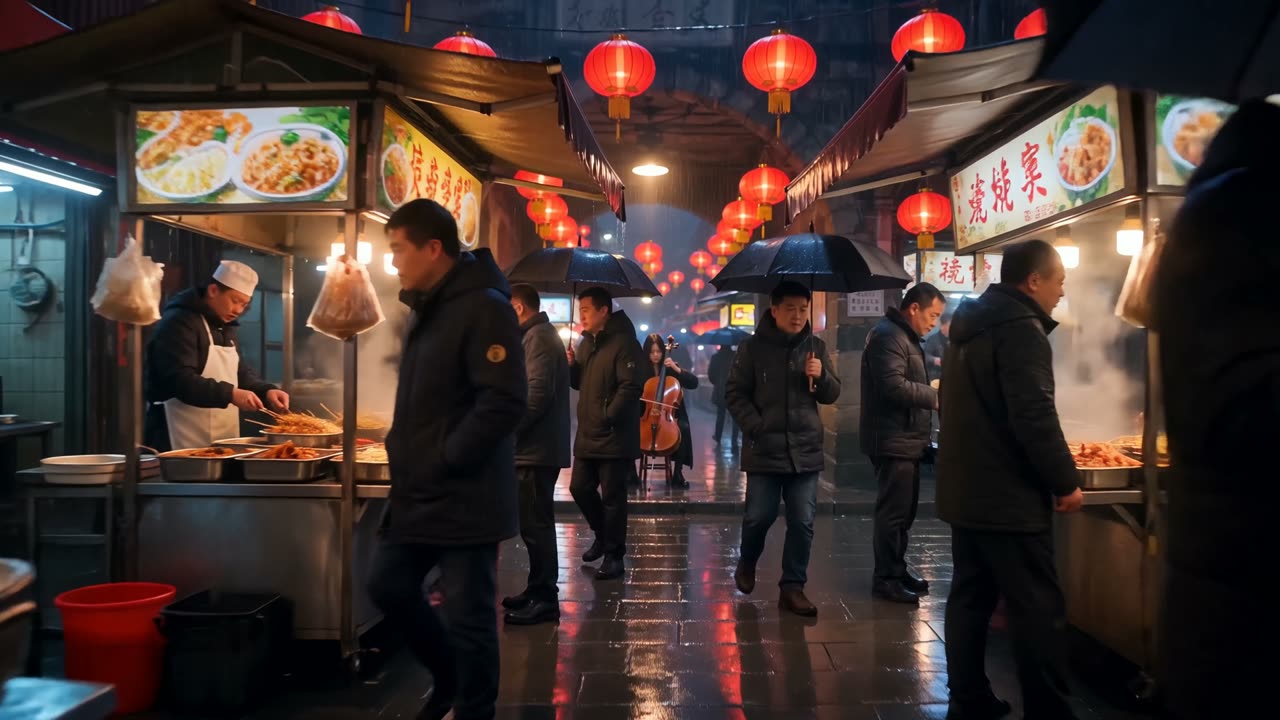
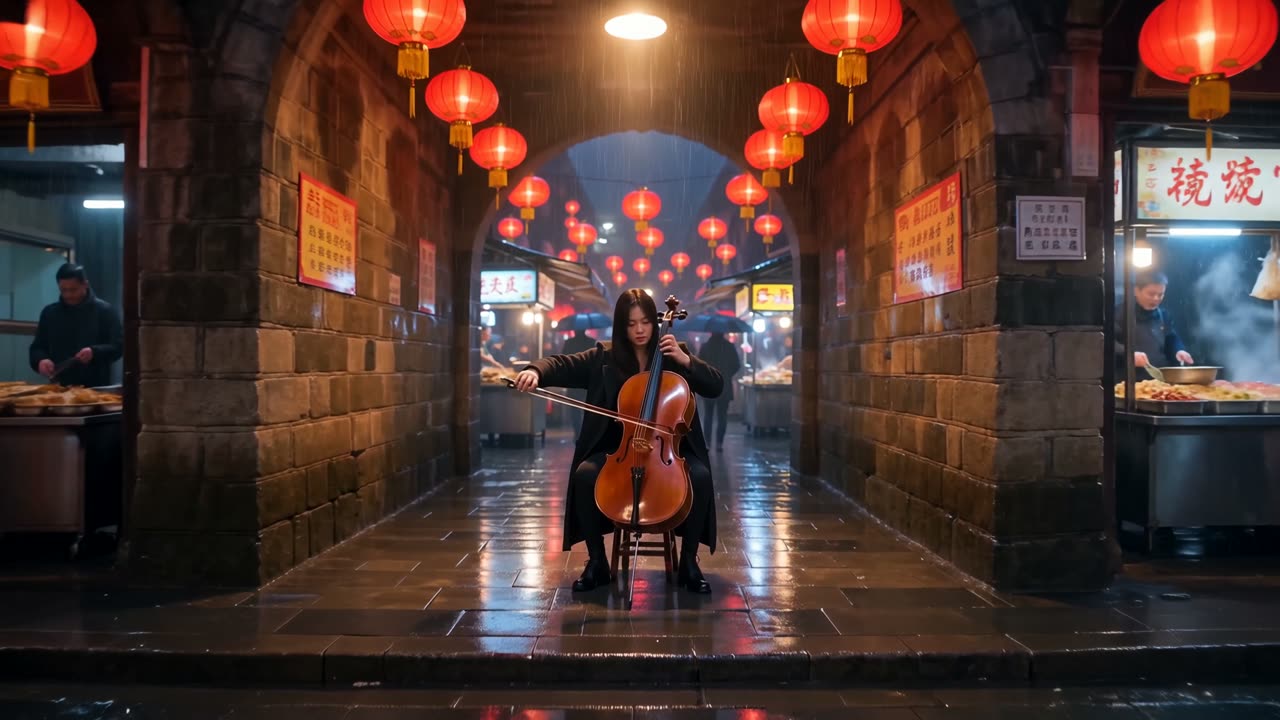
這段片段於 2026 年 10 月 14 日在 VibePaper 裡生成,規格是 16:9、1080p、5 秒。提示詞要求一個不間斷的鏡頭穿過雨中燈籠照亮的夜市,最後停在一位街頭演奏者身上。第一幀是寬景:紅燈籠下排列著小吃攤,廚師在明火上翻烤,鍋邊冒著熱氣。中段的畫面已經走進人群,前景是撐傘的人和攤位招牌。最後一幀停在石砌拱門裡,一位大提琴手坐在中央,頭頂是燈籠。
我們測試時生成的真實片段
下面的片段來自同一次生成。網頁版是 720p 且靜音,從原始的 1080p 檔案重新編碼。截圖取自同一片段的幀,尺寸與影片一致。
在 VibePaper 裡做一段 Wan 3.0 影片
- 01打開影片模式在影片生成頁面,把頂部的標籤從「圖片」切換到「影片」。頁面提供圖片、影片和文字三個選項。
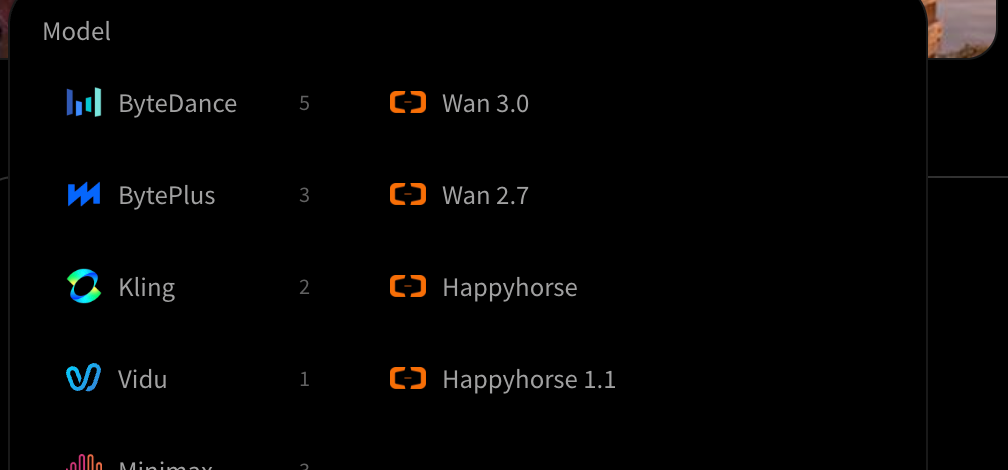
- 02在模型選擇器裡選 Wan 3.0先選模型,再調其他設置,這樣你設定的比例、分辨率和時長對應的是將要使用的模型。
- 03選擇輸入模式輸入模式切換提供「首尾幀」和「參考」。開場畫面已經確定時用「首尾幀」;想把圖片、影片或音頻作為引導時用「參考」。
- 04把提示詞寫成一個鏡頭按順序寫出一個不間斷的鏡頭:地點、一個動作、一次運鏡、光線,以及你想要的聲音。我們的測試提示詞是一個鏡頭、一條運鏡路徑,比一次改很多處更容易判斷結果。
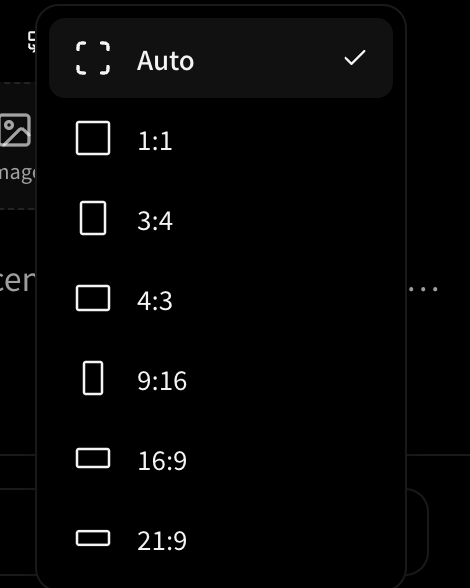
- 05檢查設置,然後生成提交前在設置欄裡確認比例、分辨率和時長。對照提示詞檢查結果;如果某一處不對,只改一處再生成一次,而不是整段重寫。
各項設置在哪裡
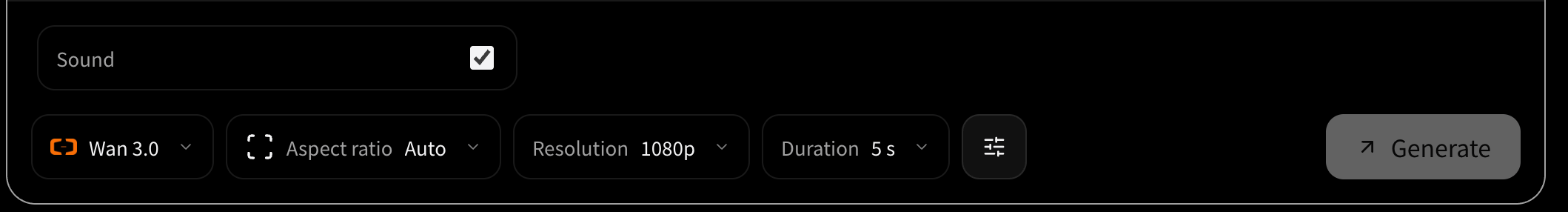
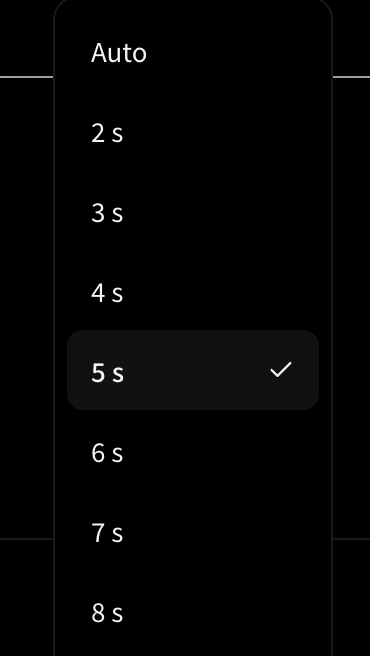
設置欄位於提示詞框下方,緊挨「生成」按鈕。下面的截圖從左到右依次是:模型、比例、分辨率和時長。截圖取自英文版 Paper Gen 介面。
限制與未解決的問題
功能列表說明模型本來要做什麼,限制才決定它適不適合你的工作。下面是我們確認過和沒能確認的內容。
- 我們還沒有生成過 30 秒的片段。官方上限是 30 秒,但我們唯一的測試結果是 5 秒,所以無法描述更長鏡頭的樣子。
- 參考素材有總時長限制。參考影片和參考音頻各自在單次請求中合計不超過 15 秒,過長的參考素材需要先剪短。
- 部分模式可接受的素材更少。首幀模式和首尾幀模式只接受圖片,不接受音頻。
- 我們檢查時,「生成」按鈕上沒有顯示 Wan 3.0 的價格,我們讀過的 API 參考也沒有列出價格,所以本文不給出價格。提交前請在產品裡確認價格。
- 聲音質素,以及 Wan 3.0 的口型或人聲表現,本文都沒有評判。我們只做了一次測試,也沒有做專門的聽感評估。
第一次嘗試的提示詞清單
一個不間斷的鏡頭,沒有切換。鏡頭以走路的高度穿過雨中狹窄的夜市,經過冒著熱氣的明火烤架,最後停在石砌拱門裡,一位大提琴手在那裡演奏。溫暖的燈籠光與藍色的雨夜形成對比,濕地面映出燈籠的倒影,寫實風格,畫面無文字。關於 Wan 3.0 的常見問題
Wan 3.0 單次生成最長多久?
阿里雲 Model Studio 公佈的範圍是每次 2 到 30 秒,預設 5 秒。把時長設為 -1 會啟用智能時長。我們唯一的測試片段是 5 秒。
Wan 3.0 會生成聲音嗎?
API 的聲音參數預設開啟,輸出會帶音軌。我們沒有做聽感評估,所以本文不評判聲音質素。我們發佈的網頁版是靜音的。
可以添加哪些參考素材?
參考模式下,最多 10 張圖片、5 段影片和 5 段音頻。參考影片和參考音頻各自合計不超過 15 秒。首幀模式和首尾幀模式只接受圖片。
支援 1080p 嗎?
API 支援 480P、720P 和 1080P,預設是 1080P。我們的測試片段是 1080p。生成前請在 VibePaper 裡查看分辨率設置,實際可選的項目以頁面顯示為準。
為什麼這篇文章只展示 5 秒的片段?
它是我們目前唯一的 Wan 3.0 結果。與其展示一段我們沒有生成過的長片段,不如展示我們真正做出來的內容。在對長鏡頭下結論之前,下一步應該做一次 30 秒的測試。
參考資料與本文範圍
技術概念以下列官方資料與原始來源為準。文中的工作流程建議和示例屬於編輯分析,並不保證效果。
- Wan3.0 影片生成 API 參考,阿里雲 Model Studio來源:2 到 30 秒的時長範圍、480P/720P/1080P 分辨率、30 fps、MP4(H.264)輸出、參考圖片、影片和音頻的限制,以及聲音參數的預設值。