VIBEPAPER JOURNAL / AI CREATION
Wan 3.0 实测:一镜到底的长镜头怎么用、我们看到了什么,以及还没验证的部分
VibePaper · 更新于
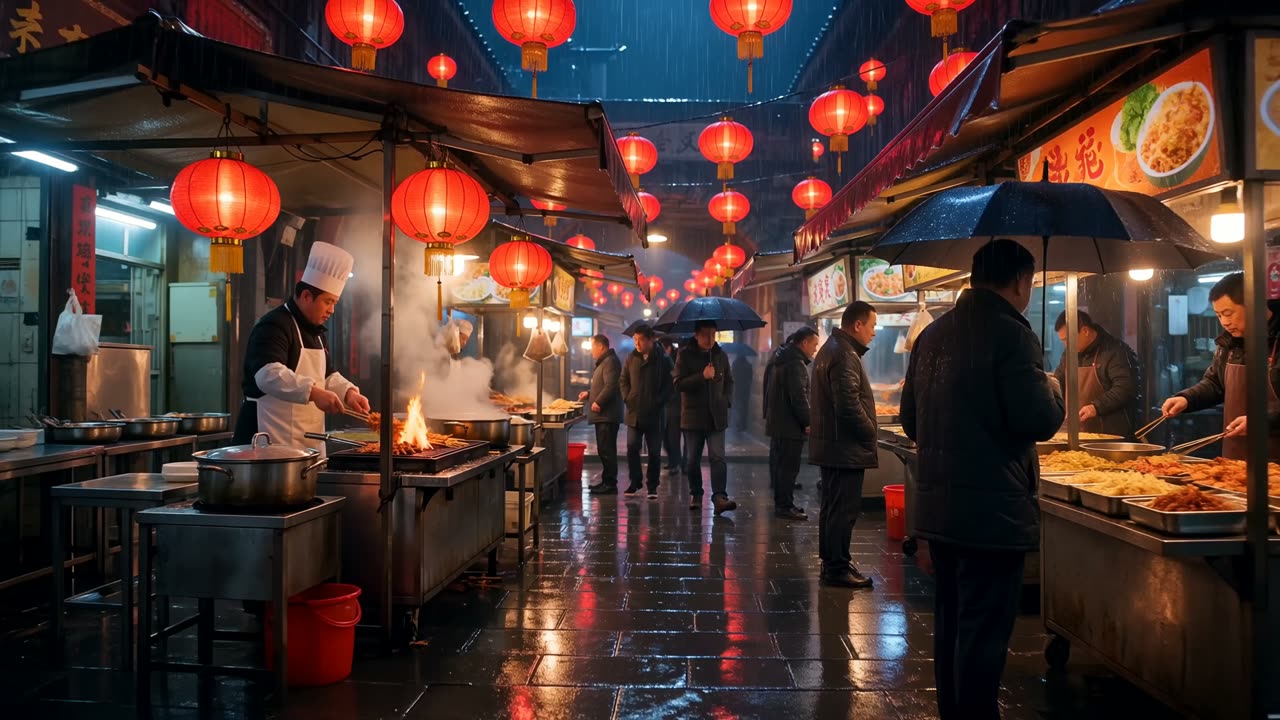
Wan 3.0 是阿里云推出的视频模型,主打更长的一镜到底场景。官方公布的上限是一次生成最长 30 秒、1080p,并且可以同时生成声音,还能把图片、视频和音频作为参考输入。我们在 VibePaper 的视频生成器里生成了一段 5 秒、1080p 的测试片段:雨中的夜市,最后停在一位在拱门下拉大提琴的人身上。这段片段不能证明 30 秒的上限,它只展示了我们测试的时长下,一个连续镜头大致是什么样子,以及哪些官方数字是我们还没有亲眼见到的。
- Wan 3.0
- AI 视频生成
- 一镜到底
- 参考生视频
- 原生声音
一览
| 能力 | 官方公布的数字或表现 | 实际意味着什么 |
|---|---|---|
| 单次时长 | 每次 2 到 30 秒;默认 5 秒;设为 -1 时由模型按提示词选择时长 | 生成前先设定时长。我们唯一的测试片段是 5 秒。 |
| 分辨率与帧率 | 480P、720P 或 1080P(API 默认 1080P);30 fps | 我们的测试片段是 1080p。本文网页上的版本是 720p。 |
| 声音 | 声音参数默认开启,输出会带音轨 | 测试文件有音轨。我们发布的网页版是静音的。 |
| 参考素材 | 最多 10 张图片;5 段视频和 5 段音频,各自合计不超过 15 秒 | 参考模式可以添加这些素材。每个文件都应该回答镜头里需要回答的一个问题。 |
| 首尾帧 | 首帧模式和首尾帧模式各接受一张图片 | 这两种模式不接受音频参考。 |
| 输出 | MP4,H.264 编码 | 可以直接用于剪辑或放到页面上。 |
Wan 3.0 改了什么
最明显的变化是时长。前几代万相更多围绕较短的片段,Wan 3.0 把一次生成的上限提到了 30 秒。API 文档把它描述为基于参考的模型:图片、视频和音频可以一起输入,输出也可以带声音。
对创作者来说,这改变了第一次尝试的样子。过去需要几段短片再粗略拼接的场景,原则上可以先当作一个镜头来试。但一个场景能不能从头到尾站得住,要靠每个人用自己的素材去检验。官方公布的数字是上限,不是对每条提示词的承诺。
Wan 3.0 的能力细节
一镜到底,最长 30 秒
API 接受的时长是 2 到 30 秒,帧率 30 fps,默认 5 秒。把时长设为 -1,会启用智能时长,由模型根据提示词决定长度。我们还没有跑过 30 秒的生成,所以无法描述更长的镜头怎样保持连贯。我们 5 秒片段能说明的内容,放在下面的实测部分。
同一次生成里的声音
声音参数默认为开启,也就是说生成的视频会包含音轨。我们测试的文件有一条立体声 AAC 音轨。我们没有做专门的听感评估,所以这篇文章不评判声音的质量。我们发布的网页版去掉了音轨:页面以静音方式自动播放,去掉音轨也让文件更小。
图片、视频与音频参考
参考生视频最多接受 10 张图片、5 段视频和 5 段音频。每段参考视频为 1 到 15 秒,所有参考视频的合计时长不能超过 15 秒;参考音频的规则相同。音频在参考模式里作为参考输入,可以和参考图片、参考视频一起使用。首帧模式和首尾帧模式只接受图片。
产品卡片上写着,这些参考能让 Wan 3.0 在整个镜头里跟住同一个角色。API 文档说明了输入是怎样传入的,但没有说明一个角色在 30 秒里能保持到什么程度,这一点我们没有测试过。
我们的测试片段能说明什么
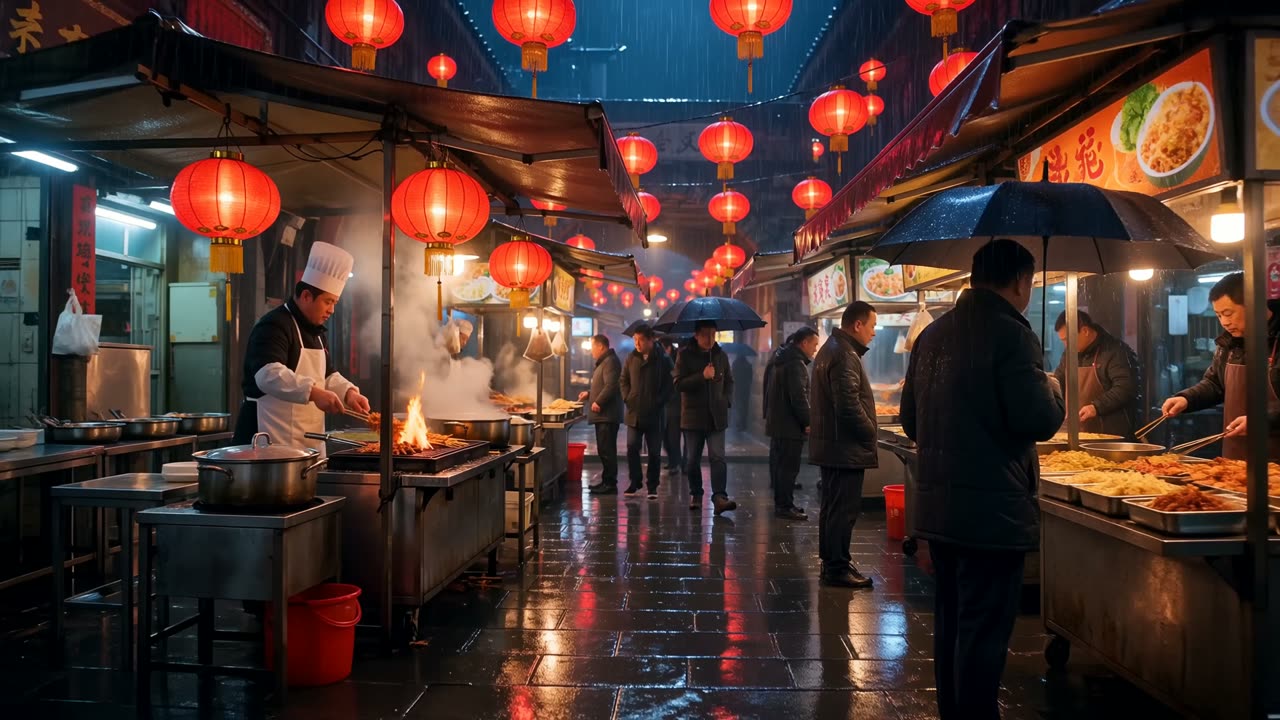
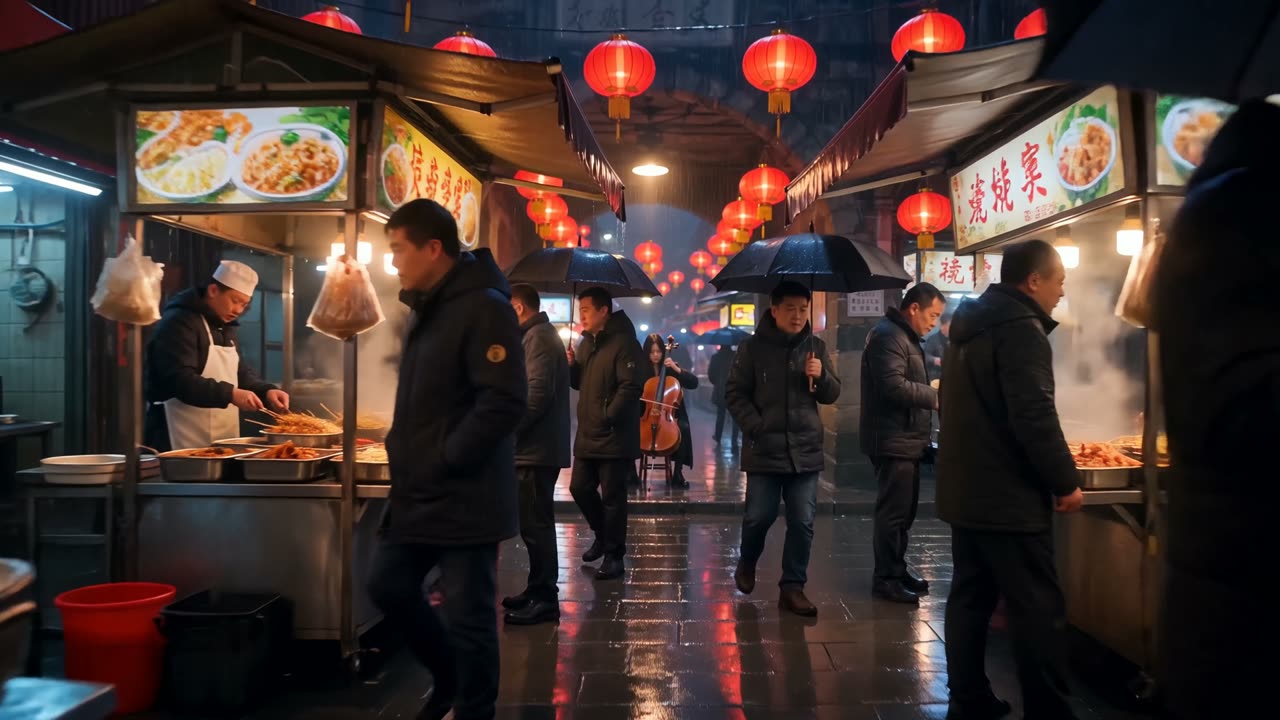
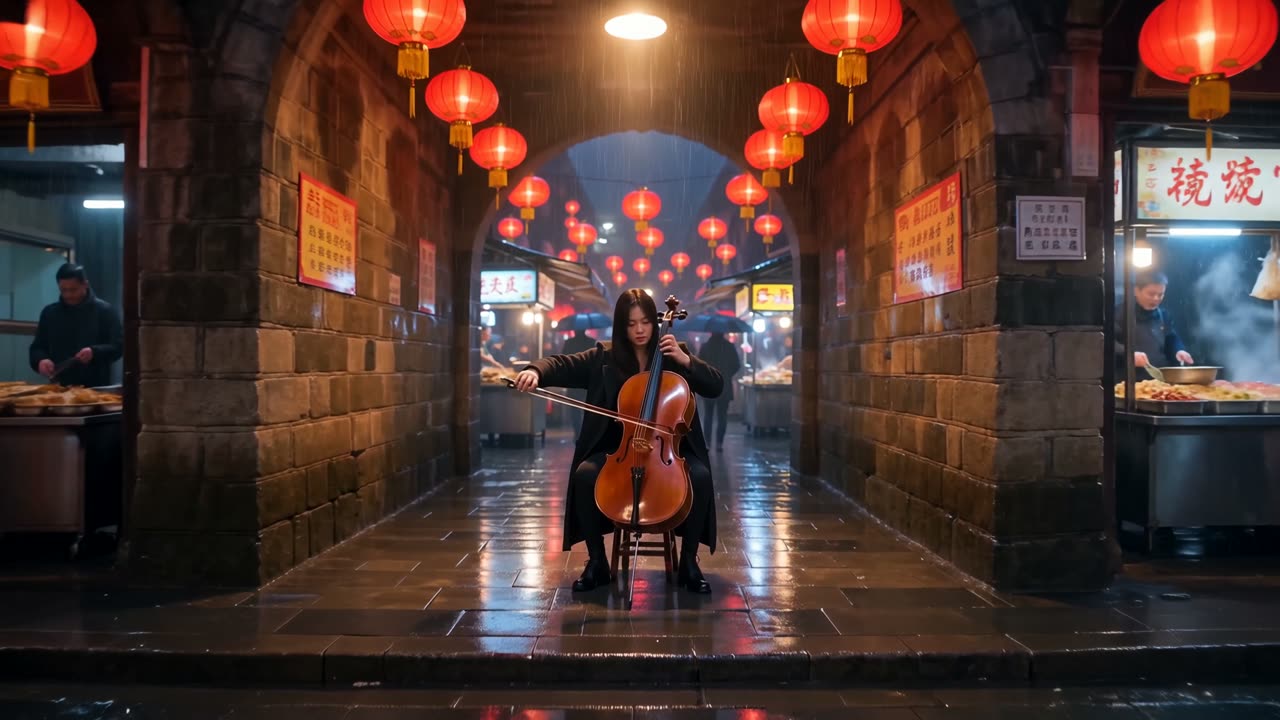
这段片段于 2026 年 10 月 14 日在 VibePaper 里生成,规格是 16:9、1080p、5 秒。提示词要求一个不间断的镜头穿过雨中灯笼照亮的夜市,最后停在一位街头演奏者身上。第一帧是宽景:红灯笼下排列着小吃摊,厨师在明火上翻烤,锅边冒着热气。中段的画面已经走进人群,前景是撑伞的人和摊位招牌。最后一帧停在石砌拱门里,一位大提琴手坐在中央,头顶是灯笼。
我们测试时生成的真实片段
下面的片段来自同一次生成。网页版是 720p 且静音,从原始的 1080p 文件重新编码。截图取自同一片段的帧,尺寸与视频一致。
在 VibePaper 里做一段 Wan 3.0 视频
- 01打开视频模式在视频生成页面,把顶部的标签从「图片」切换到「视频」。页面提供图片、视频和文字三个选项。
- 02在模型选择器里选 Wan 3.0先选模型,再调其他设置,这样你设定的比例、分辨率和时长对应的是将要使用的模型。
- 03选择输入模式输入模式切换提供「首尾帧」和「参考」。开场画面已经确定时用「首尾帧」;想把图片、视频或音频作为引导时用「参考」。
- 04把提示词写成一个镜头按顺序写出一个不间断的镜头:地点、一个动作、一次运镜、光线,以及你想要的声音。我们的测试提示词是一个镜头、一条运镜路径,比一次改很多处更容易判断结果。
- 05检查设置,然后生成提交前在设置栏里确认比例、分辨率和时长。对照提示词检查结果;如果某一处不对,只改一处再生成一次,而不是整段重写。
各项设置在哪里
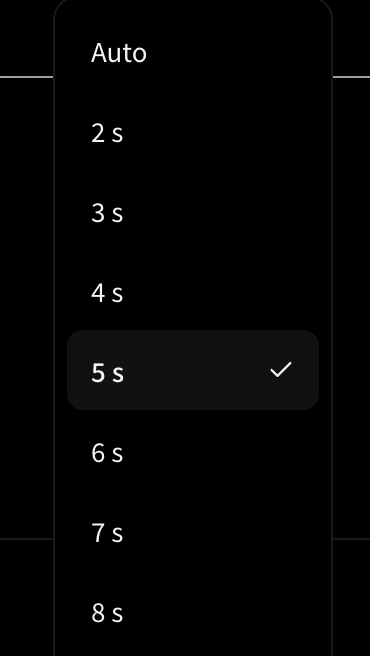
设置栏位于提示词框下方,紧挨「生成」按钮。下面的截图从左到右依次是:模型、比例、分辨率和时长。截图取自英文版 Paper Gen 界面。
限制与未解决的问题
功能列表说明模型本来要做什么,限制才决定它适不适合你的工作。下面是我们确认过和没能确认的内容。
- 我们还没有生成过 30 秒的片段。官方上限是 30 秒,但我们唯一的测试结果是 5 秒,所以无法描述更长镜头的样子。
- 参考素材有总时长限制。参考视频和参考音频各自在单次请求中合计不超过 15 秒,过长的参考素材需要先剪短。
- 部分模式可接受的素材更少。首帧模式和首尾帧模式只接受图片,不接受音频。
- 我们检查时,「生成」按钮上没有显示 Wan 3.0 的价格,我们读过的 API 参考也没有列出价格,所以本文不给出价格。提交前请在产品里确认价格。
- 声音质量,以及 Wan 3.0 的口型或人声表现,本文都没有评判。我们只做了一次测试,也没有做专门的听感评估。
第一次尝试的提示词清单
一个不间断的镜头,没有切换。镜头以走路的高度穿过雨中狭窄的夜市,经过冒着热气的明火烤架,最后停在石砌拱门里,一位大提琴手在那里演奏。温暖的灯笼光与蓝色的雨夜形成对比,湿地面映出灯笼的倒影,写实风格,画面无文字。关于 Wan 3.0 的常见问题
Wan 3.0 单次生成最长多久?
阿里云 Model Studio 公布的范围是每次 2 到 30 秒,默认 5 秒。把时长设为 -1 会启用智能时长。我们唯一的测试片段是 5 秒。
Wan 3.0 会生成声音吗?
API 的声音参数默认开启,输出会带音轨。我们没有做听感评估,所以本文不评判声音质量。我们发布的网页版是静音的。
可以添加哪些参考素材?
参考模式下,最多 10 张图片、5 段视频和 5 段音频。参考视频和参考音频各自合计不超过 15 秒。首帧模式和首尾帧模式只接受图片。
支持 1080p 吗?
API 支持 480P、720P 和 1080P,默认是 1080P。我们的测试片段是 1080p。生成前请在 VibePaper 里查看分辨率设置,实际可选的项目以页面显示为准。
为什么这篇文章只展示 5 秒的片段?
它是我们目前唯一的 Wan 3.0 结果。与其展示一段我们没有生成过的长片段,不如展示我们真正做出来的内容。在对长镜头下结论之前,下一步应该做一次 30 秒的测试。
参考资料与阅读边界
技术概念以所列官方资料与原始来源为准。文中的工作流建议和示例属于编辑分析,不构成效果保证。
- Wan3.0 视频生成 API 参考,阿里云 Model Studio来源:2 到 30 秒的时长范围、480P/720P/1080P 分辨率、30 fps、MP4(H.264)输出、参考图片、视频和音频的限制,以及声音参数的默认值。