AI 畫布工作流:我為什麼不再在對話框裏出圖
對話式出圖挺好用,直到你需要回頭的那一刻。跟着一組小小的球鞋物料走一遍畫布,就知道畫布贏在哪,也知道它在哪兒多餘。
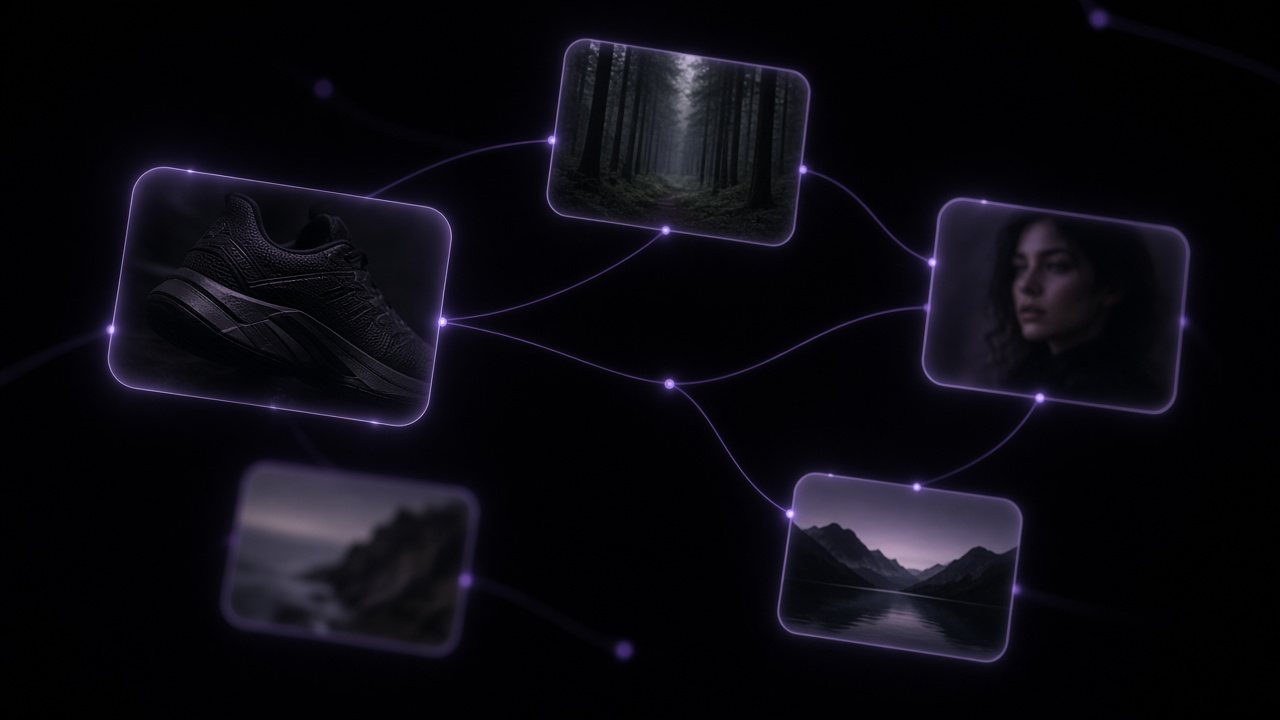
我以前也是按大多數 AI 工具引導的方式幹活:輸入、生成、往上翻、再輸入。很快,直到你冒出一句“二十分鐘前那版更好”,接下來就變成了考古。
節點式 AI 畫布的解法,是把歷史本身變成界面。每一條提示詞、每張參考圖、每個模型、每個結果都是畫布上的一個東西,並且連着生成它的那些輸入。
一組物料,在畫布上走一遍
假設需求是:一雙黑色跑鞋,要一張產品頁主圖,外加一條豎屏短視頻。
- 先把鞋的實拍參考圖放上畫布,後面所有東西都連到它。
- 同一條提示詞交給兩個圖片模型,暗色棚拍主圖。兩個結果都留着。
- 好的那張分出兩支:一張局部特寫,一張放在濕漉漉的柏油路上。
- 柏油路那張靜幀,成為一條 9:16 視頻鏡頭的首幀。
- 客户説“要早先那版,但放到柏油路上”。它就在畫布上,連過去,再跑一次。
畫布不會讓你更快拿到第一個結果,它讓你更快拿到第五個。
對比模型,別騙自己
只有並排才是公平的對比。在對話框裏一個一個出結果,最新那個總是顯得最好。在畫布上,同一個輸入、兩個模型的結果挨在一起,差別一眼就看出來。
什麼時候畫布是多餘的
一次性的圖、隨手做的表情包、以後再也不會碰的東西。這些直接用 AI 圖片生成器頁面更快,完全沒問題。畫布真正值回票價,是在有需求、有修改、還有不止一個人有意見的時候。
閲讀 VibePaper 2.0 介紹Canvas、Design 與 Work,以及一個項目怎麼在三者之間流轉。常見問題
一塊畫布上能混用圖片和視頻模型嗎?
能。圖片模型出的靜幀可以直接接到同一畫布上的視頻模型。